Python e database: SQLite, MySQL, SQL e operazioni CRUD
Classe seconda — Liceo scientifico, Scienze applicate · Python 3.13
Da file TXT, CSV e JSON a database strutturati: imparerai a creare tabelle, collegare Python a SQLite, applicare le quattro operazioni CRUD, interpretare errori e transazioni e realizzare un piccolo archivio scientifico. MySQL verrà presentato come alternativa client-server facoltativa.
Prerequisiti: variabili, funzioni, cicli, liste, dizionari, eccezioni e file (articoli B1.01–B1.06). Risultati attesi: scegliere quando utilizzare un DBMS; eseguire query parametrizzate; gestire connessioni e transazioni; leggere e analizzare misure. Confine: modello ER, normalizzazione, progettazione relazionale sistematica e SQL avanzato rimangono nel Blocco D.
15.1 — Dalla persistenza dei file ai database
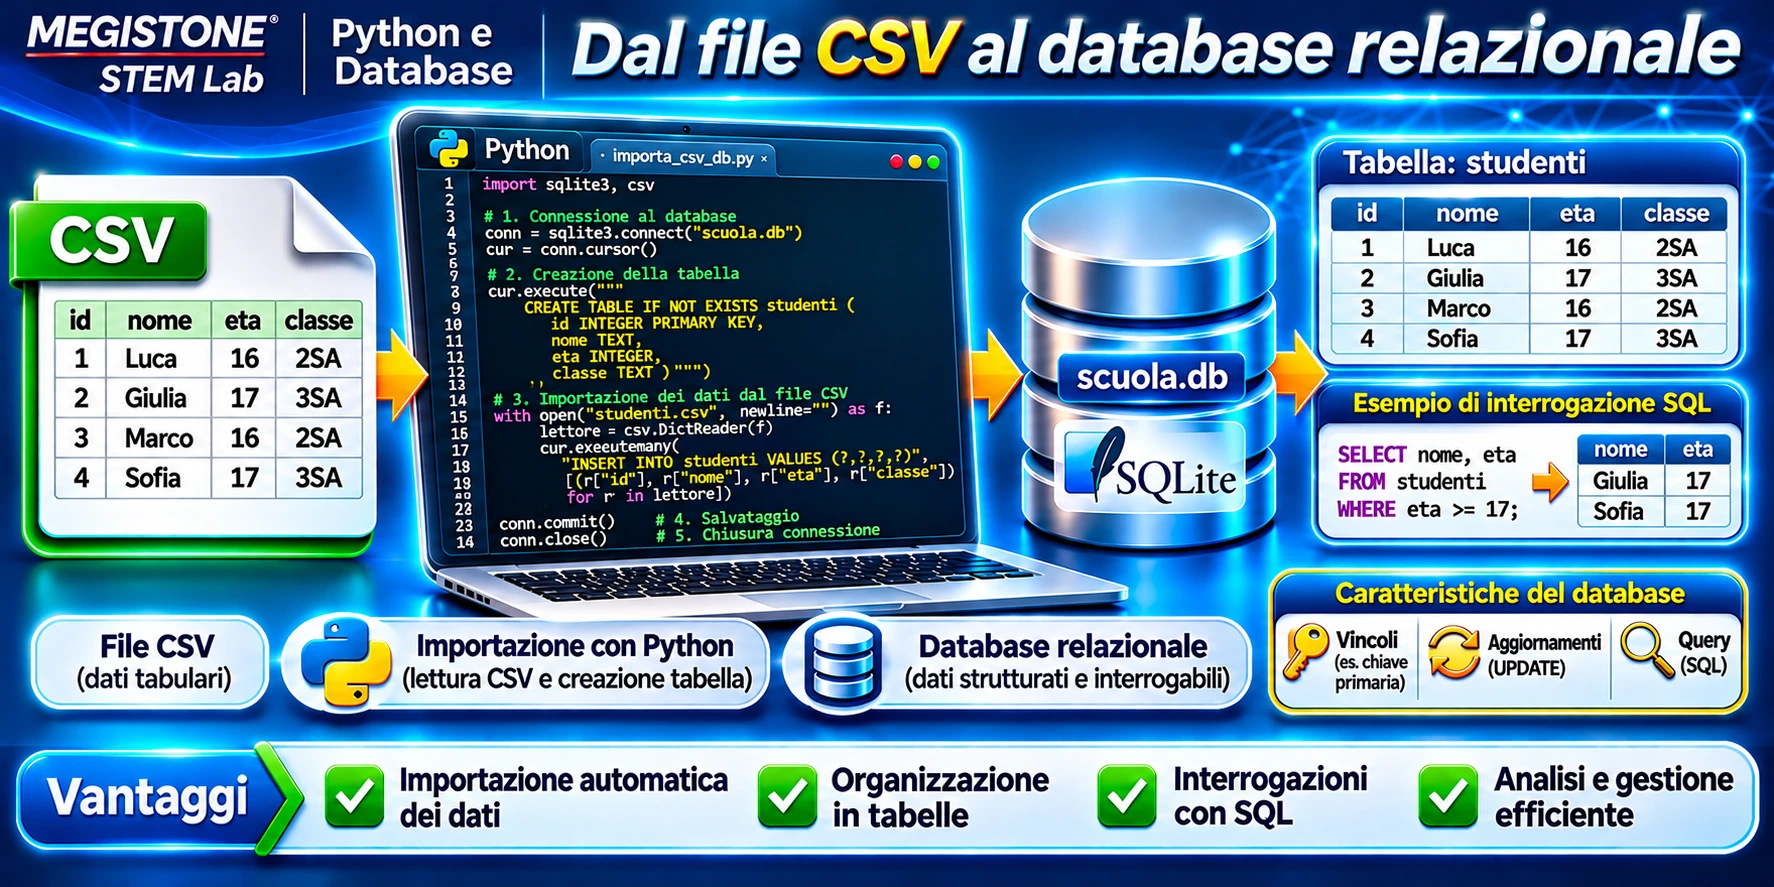
Nel capitolo B1.06 abbiamo salvato misure in file TXT, CSV, JSON e binari. Questo approccio è utile per registrazioni sequenziali, esportazione e condivisione. Immaginiamo però un archivio con migliaia di misure: trovare una temperatura specifica, correggerla senza riscrivere tutto il file o consentire accessi coordinati diventa più difficile.
Un database organizza dati destinati a durare nel tempo; un DBMS è il software che permette di conservarli, interrogare e modificare in modo controllato. Un programma Python può chiedere al DBMS di trovare soltanto le righe necessarie. La ridondanza (ripetere informazioni) può produrre incoerenze, per esempio lo stesso esperimento scritto con nomi differenti.
Il DBMS offre strumenti per vincoli, transazioni e accessi concorrenti, ma non elimina automaticamente ogni errore: occorre progettare e validare. Un CSV resta preferibile quando serve un formato semplice, portabile e leggibile; SQLite è vantaggioso per piccole applicazioni che devono ricercare e aggiornare record. I server DBMS rispondono meglio a scenari multiutente più impegnativi.
15.2 — Che cos’è un database
Dato: «21,5»; informazione: «temperatura del laboratorio = 21,5 °C, misurata il 12 novembre». Il contesto rende interpretabile il valore.
Un database contiene dati organizzati secondo uno schema. In una tabella ogni riga è un record e ogni colonna è un campo/attributo. Il DBMS SQLite gestisce il database, mentre lo script Python è l’applicazione che dialoga con esso: non sono la stessa cosa.
| id | data | temperatura | luogo |
|---|---|---|---|
| 1 | 2026-11-10 | 19.5 | Aula |
| 2 | 2026-11-11 | 20.0 | Aula |
| 3 | 2026-11-12 | 21.5 | Laboratorio |
La colonna id identifica univocamente ogni record ed è una chiave primaria. Due osservazioni possono avere lo stesso valore di temperatura ma non lo stesso identificativo.
15.3 — Introduzione ai database relazionali
Nel modello relazionale i dati sono rappresentati mediante relazioni, comunemente visualizzate come tabelle. Un record descrive un’osservazione; una chiave primaria individua univocamente ciascuna riga. NOT NULL, UNIQUE e CHECK sono esempi di vincoli che proteggono la qualità dei dati.
NULL significa valore sconosciuto o assente, non zero e non stringa vuota. In SQL il controllo di un valore mancante usa IS NULL, non = NULL. Tabelle diverse possono essere collegate tramite identificativi, ma qui ci concentriamo sull’uso operativo di una singola tabella: progettazione ER e normalizzazione saranno affrontate nel Blocco D.
15.4 — SQLite: caratteristiche e applicazioni
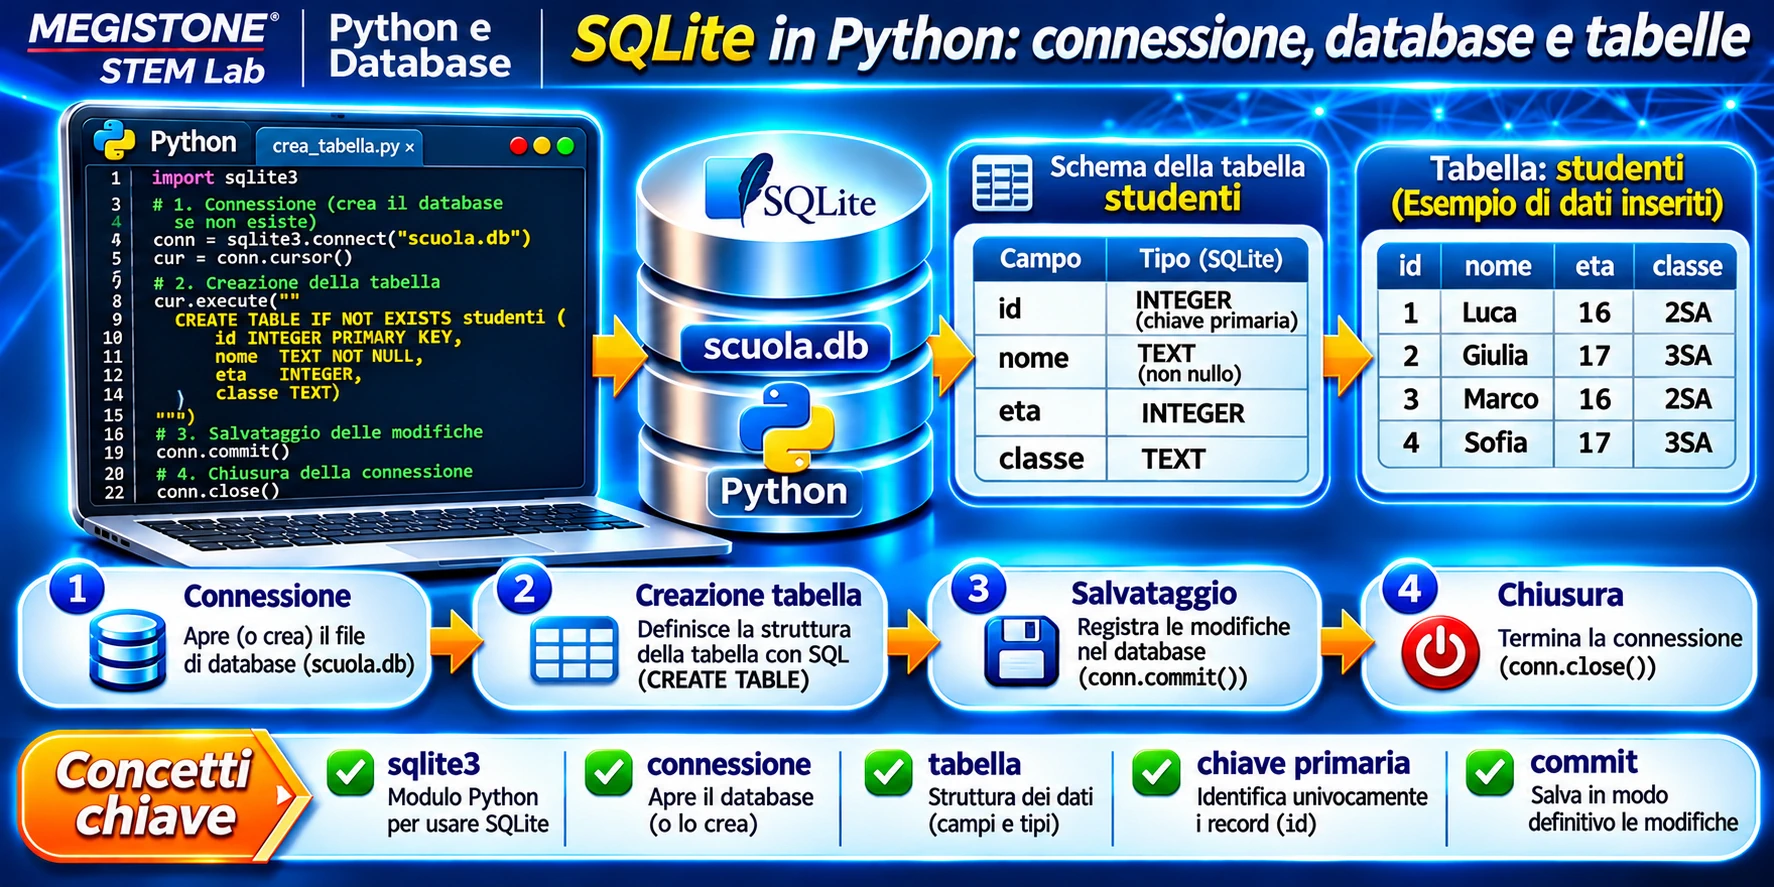
SQLite è un DBMS relazionale incorporato: il motore viene usato direttamente dal programma e normalmente memorizza il database in un file, per esempio laboratorio.db. Non occorre avviare un server separato. Le query SQL operano su tabelle, non sulla sintassi di un CSV.
Vantaggi: semplicità, portabilità, installazione minima, supporto alle transazioni e buona integrazione con Python. Limiti: scritture concorrenti regolate da blocchi e minore aderenza a scenari con numerosi client remoti; per questi possono essere più adatti DBMS client-server. SQLite può anche operare in memoria, con :memory:, per prove temporanee.
Una transazione raggruppa operazioni che possono essere confermate oppure annullate; ne vedremo l’impiego pratico.
15.5 — Il modulo sqlite3 di Python
La libreria standard Python include sqlite3. connect() apre una connessione, execute() invia SQL, fetchone() legge una riga, fetchmany(n) ne legge fino a n, fetchall() legge tutte le righe restanti. commit() conferma, rollback() annulla modifiche non confermate, close() rilascia la connessione.
Il cursor conserva lo stato di una query e permette di recuperare progressivamente i risultati. Connection.execute() è una scorciatoia che restituisce un cursor. Non è necessario creare esplicitamente un cursor per ogni query elementare.
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    conn.execute("CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL)")
    conn.execute("INSERT INTO misure (valore) VALUES (?)", (21.5,))
    conn.commit()
    cursor = conn.execute("SELECT valore FROM misure")
print(cursor.fetchone()[0])21.5
Attenzione: with sqlite3.connect(...) da solo gestisce il confine della transazione, non garantisce la chiusura della connessione. Per questo esempio usiamo contextlib.closing.
15.6 — Creazione di un database SQLite
pathlib costruisce percorsi indipendenti dal sistema operativo. Se l’esempio è salvato in uno script, Path(__file__).resolve().parent indica la cartella dello script; in una console interattiva si può usare Path.cwd().
from pathlib import Path
import sqlite3
from contextlib import closing

cartella = Path.cwd() / "dati_esercizi"
cartella.mkdir(parents=True, exist_ok=True)
percorso = cartella / "laboratorio.db"
with closing(sqlite3.connect(percorso, autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE IF NOT EXISTS prove (id INTEGER PRIMARY KEY, nome TEXT NOT NULL)")
print(percorso.name)laboratorio.db
IF NOT EXISTS evita l’errore se la tabella è già presente, ma non aggiorna automaticamente uno schema precedente. Per un esercizio che non lascia file, sostituisci il percorso con ":memory:".
15.7 — Linguaggio SQL: istruzioni fondamentali
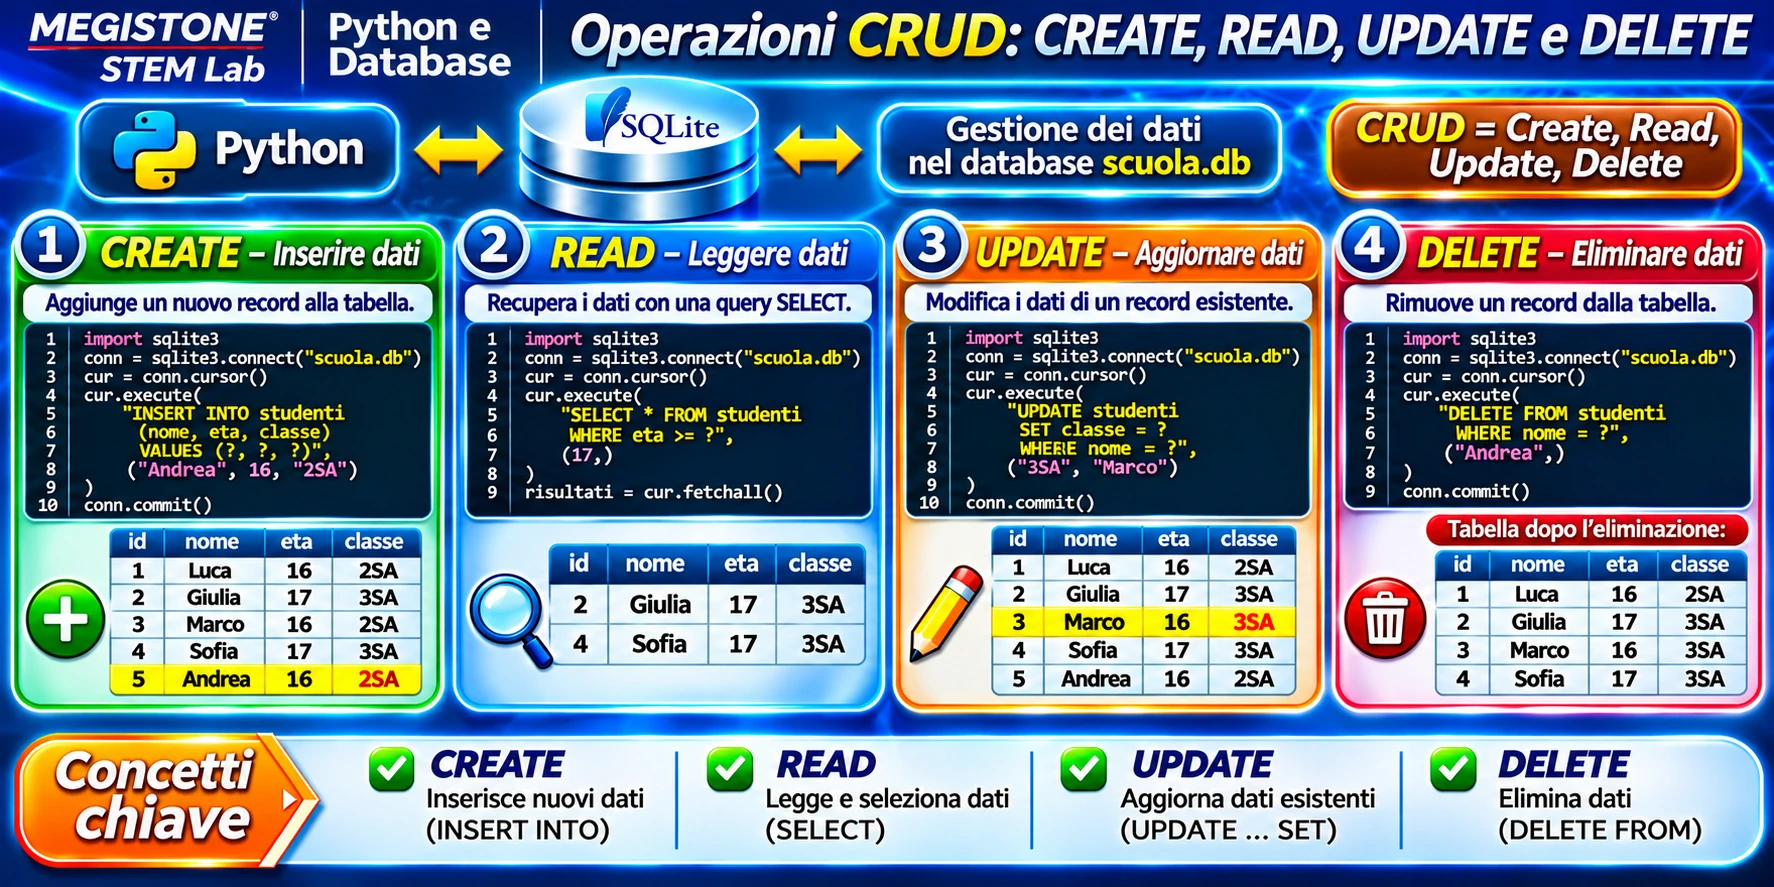
SQL (Structured Query Language) è il linguaggio usato per definire e interrogare dati relazionali. Python gestisce input e logica del programma; SQL descrive l’operazione sul database. DDL comprende comandi come CREATE TABLE; DML comprende INSERT, UPDATE e DELETE. SELECT è la query di lettura, spesso classificata come DQL.
CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL NOT NULL);
INSERT INTO misure (valore) VALUES (20.5);
SELECT id, valore FROM misure WHERE valore >= 20 ORDER BY valore DESC LIMIT 5;
UPDATE misure SET valore = 21 WHERE id = 1;
DELETE FROM misure WHERE id = 1;
Le clausole WHERE, ORDER BY e LIMIT filtrano, ordinano e limitano i risultati. L’ordine dei comandi mostrato è didattico: una query agisce sullo stato corrente della tabella.
15.8 — Creazione e struttura delle tabelle
SQLite usa affinità di tipo, un sistema più flessibile di quello adottato da molti DBMS. Le principali classi di memorizzazione sono NULL, INTEGER, REAL, TEXT, BLOB. L’affinità suggerisce come interpretare e convertire valori: in una normale tabella SQLite il tipo dichiarato non impone sempre una tipizzazione rigida; esistono anche tabelle STRICT con regole più restrittive.
CREATE TABLE esperimenti (
    id INTEGER PRIMARY KEY,
    titolo TEXT NOT NULL UNIQUE,
    temperatura REAL CHECK (temperatura BETWEEN -273.15 AND 1000),
    descrizione TEXT
);
In SQLite una colonna INTEGER PRIMARY KEY (in una normale tabella rowid) è un alias del rowid e può ottenere un identificativo automaticamente. AUTOINCREMENT è opzionale, ha semantica più specifica e non va aggiunto indiscriminatamente. Il vincolo CHECK non è un sostituto della validazione applicativa; inoltre l’esempio permette NULL nella temperatura, perché manca NOT NULL.
15.9 — CREATE: inserire dati nel database
La C di CRUD significa Create, cioè inserire record; non va confusa con il comando SQL CREATE TABLE, che crea la struttura della tabella. I dati esterni passano sempre attraverso parametri SQL, non tramite concatenazione di stringhe.
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE dati (id INTEGER PRIMARY KEY, valore REAL NOT NULL)")
        primo = conn.execute("INSERT INTO dati(valore) VALUES (?)", (19.5,))
        print("ID:", primo.lastrowid)
        conn.executemany("INSERT INTO dati(valore) VALUES (?)", [(20.0,), (21.5,)])
print("Righe:", conn.execute("SELECT COUNT(*) FROM dati").fetchone()[0])ID: 1 Righe: 3
Nella tupla (19.5,) la virgola è necessaria: crea una sequenza con un solo elemento. executemany() invia la stessa istruzione per più gruppi di parametri. Se il valore non è valido, rifiutalo prima di inserirlo; i vincoli SQL rimangono una seconda linea di difesa.
15.10 — READ: interrogare il database
La R di CRUD corrisponde a Read. Con SELECT scegli colonne, condizioni e ordinamento. Un risultato vuoto non è un errore: fetchone() restituisce None se non ci sono righe, mentre fetchall() restituisce una lista vuota.
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    conn.row_factory = sqlite3.Row
    with conn:
        conn.execute("CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL)")
        conn.executemany("INSERT INTO misure(valore) VALUES (?)", [(19.5,), (21.5,)])
    righe = conn.execute("SELECT id, valore FROM misure WHERE valore > ? ORDER BY valore", (20,)).fetchall()
    for riga in righe:
        print(riga["id"], f"{riga['valore']:.2f}")
print("Assente:", conn.execute("SELECT * FROM misure WHERE id = ?", (99,)).fetchone())2 21.50 Assente: None
In modalità predefinita ogni riga letta è una tupla; con sqlite3.Row si può accedere per nome come riga["valore"], ma Row non è esattamente un dizionario. Con dict(riga) si ottiene un vero dizionario. fetchmany(10) è utile per letture a blocchi.
15.11 — UPDATE: modificare i dati
La U significa Update: modifica un record già esistente. Prima di cambiare una misura verifica identificativo e valore. Una UPDATE priva di una condizione adeguata può cambiare tutte le righe: è un errore grave in un archivio reale.
# Con conn già aperta e tabella misure creata:
with conn:
    risultato = conn.execute(
        "UPDATE misure SET valore = ? WHERE id = ?", (20.25, 1)
    )
    print("Record modificati:", risultato.rowcount)
rowcount indica quante righe sono state interessate dall’istruzione. Se vale zero, l’identificativo potrebbe non esistere. Nell’applicazione completa la funzione aggiorna() implementa questo controllo e conferma all’utente l’esito.
15.12 — DELETE: eliminare i record
La D significa Delete. DELETE FROM misure WHERE id = ? elimina una riga, mentre cancellare il file .db significa eliminare l’intero database, operazione completamente diversa. Una DELETE senza WHERE può eliminare tutte le righe.
# Su un database di esercitazione, con conn già aperta:
with conn:
    cancellati = conn.execute("DELETE FROM misure WHERE id = ?", (2,)).rowcount
    print("Eliminati:", cancellati)
Il programma MEGI richiede una conferma esplicita prima della cancellazione. Finché le modifiche non sono state confermate, un rollback può annullarle; dopo il commit non si può contare sul rollback per ricostruire i dati. Per questo servono backup e controlli.
15.13 — Gestione delle transazioni e degli errori
Le proprietà ACID descrivono, a livello introduttivo, atomicità (tutto o niente), consistenza (vincoli rispettati), isolamento (coordinamento tra transazioni) e durabilità (persistenza dopo conferma). sqlite3.IntegrityError segnala per esempio un vincolo violato; sqlite3.OperationalError può riguardare una tabella mancante o un blocco; entrambe derivano da sqlite3.Error.
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    conn.execute("CREATE TABLE voci (id INTEGER PRIMARY KEY, nome TEXT UNIQUE)")
    conn.commit()
    try:
        with conn:
            conn.execute("INSERT INTO voci(nome) VALUES (?)", ("A",))
            conn.execute("INSERT INTO voci(nome) VALUES (?)", ("A",))
    except sqlite3.IntegrityError:
        print("Vincolo violato: transazione annullata")
print("Righe rimaste:", conn.execute("SELECT COUNT(*) FROM voci").fetchone()[0])Vincolo violato: transazione annullata Righe rimaste: 0
Python 3.13: si raccomanda il controllo delle transazioni mediante il parametro autocommit. Con autocommit=False Python mantiene aperta una transazione e commit()/rollback() funzionano. Con autocommit=True quei metodi non producono lo stesso effetto; in modalità LEGACY_TRANSACTION_CONTROL il comportamento dipende anche da isolation_level. Il default di Python 3.13 è ancora la modalità legacy, quindi in questi esempi la scelta viene dichiarata esplicitamente. Il gestore with conn: conferma alla fine del blocco senza eccezioni e annulla in caso di errore, ma non chiude la connessione.
15.14 — Sicurezza e correttezza delle query SQL
Una query SQL non deve incorporare direttamente testo digitato dall’utente. La concatenazione ingenua di input e comando può alterare il significato dell’istruzione (SQL injection). I placeholder trattano i valori come dati anziché come codice SQL.
nome = input("Titolo da cercare: ")
righe = conn.execute("SELECT * FROM esperimenti WHERE titolo = ?", (nome,)).fetchall()
# Alternativa con parametro nominato:
righe = conn.execute("SELECT * FROM esperimenti WHERE titolo = :titolo", {"titolo": nome}).fetchall()
Non si possono usare placeholder per sostituire il nome di una tabella o colonna: quando gli identificatori sono dinamici, selezionarli da un insieme fisso di nomi consentiti. Validare tipo, intervallo, lunghezza e formato dei valori; proteggere i file database, eseguire backup, concedere soltanto i privilegi necessari. I dati personali richiedono cautela aggiuntiva.
15.15 — MySQL e collegamento con Python
MySQL è un DBMS relazionale generalmente usato in architettura client-server: Python si collega a un servizio che può risiedere su un altro computer. Per la connessione occorrono normalmente host, porta (spesso 3306), nome del database, utente, password e un driver esterno. SQLite, invece, è incorporato e il progetto principale non richiede MySQL.
Un esempio facoltativo usa mysql-connector-python, il connettore ufficiale della famiglia 9.x con supporto documentato a Python 3.13. Installazione in un ambiente virtuale: python -m pip install mysql-connector-python. Il codice seguente è illustrativo, non collaudato contro un server.
# Richiede un server MySQL di prova e mysql-connector-python.
import os
import mysql.connector

conn = mysql.connector.connect(
    host=os.environ["MEGI_MYSQL_HOST"],
    port=3306,
    user=os.environ["MEGI_MYSQL_USER"],
    password=os.environ["MEGI_MYSQL_PASSWORD"],
    database=os.environ["MEGI_MYSQL_DATABASE"],
)
try:
    cur = conn.cursor()
    cur.execute("SELECT id, titolo FROM esperimenti WHERE id = %s", (1,))
    print(cur.fetchall())
    conn.commit()
except mysql.connector.Error:
    conn.rollback()
    raise
finally:
    cur.close() if 'cur' in locals() else None
    conn.close()
Il placeholder %s del driver MySQL non coincide con ? di SQLite. Non salvare credenziali reali nel sorgente. Per un progetto di produzione servono anche configurazione TLS, privilegi minimi e politiche adeguate di gestione dei segreti.
15.16 — Applicazioni STEM con database
Esperimento A — Archivio delle temperature
Problema: archiviare tre misure, correggere l’ultima e calcolare numero di osservazioni, media, minimo e massimo. Dati iniziali: 19,5; 20,0; 21,5 °C. Algoritmo: crea tabella → inserisci → correggi per ID → interroga con funzioni di aggregazione → interpreta.
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE temperature (id INTEGER PRIMARY KEY, giorno TEXT, gradi REAL NOT NULL)")
        conn.executemany("INSERT INTO temperature(giorno, gradi) VALUES (?, ?)", [
            ("2026-11-10", 19.5), ("2026-11-11", 20.0), ("2026-11-12", 21.5)])
    with conn:
        conn.execute("UPDATE temperature SET gradi = ? WHERE id = ?", (21.0, 3))
    n, media, minimo, massimo = conn.execute(
        "SELECT COUNT(*), AVG(gradi), MIN(gradi), MAX(gradi) FROM temperature").fetchone()
print(f"n={n}; media={media:.2f} °C; min={minimo:.2f} °C; max={massimo:.2f} °C")n=3; media=20.17 °C; min=19.50 °C; max=21.00 °C
Interpretazione: dopo la correzione la media aritmetica è 20,17 °C. Casi limite: tabella vuota (AVG restituisce NULL), valori non numerici, misure con unità diverse e correzione di ID inesistenti. La media non esprime incertezza strumentale.
Esperimento B — Catalogo degli esperimenti
Problema: catalogare un’esperienza con titolo, data, descrizione e stato; realizzare tutte le operazioni CRUD. Dati iniziali: «Pendolo», 2026-11-17, «Periodo e lunghezza», aperto. Algoritmo: creare la tabella, inserire, leggere con SELECT, aggiornare lo stato, leggere e cancellare in modo controllato.
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("""CREATE TABLE esperimenti (id INTEGER PRIMARY KEY,
            titolo TEXT NOT NULL, data TEXT NOT NULL, descrizione TEXT, stato TEXT NOT NULL)""")
        conn.execute("INSERT INTO esperimenti(titolo,data,descrizione,stato) VALUES (?,?,?,?)",
                     ("Pendolo", "2026-11-17", "Periodo e lunghezza", "aperto"))
    print("Creati:", conn.execute("SELECT COUNT(*) FROM esperimenti").fetchone()[0])
    with conn:
        conn.execute("UPDATE esperimenti SET stato=? WHERE id=?", ("completato", 1))
    print("Stato:", conn.execute("SELECT stato FROM esperimenti WHERE id=?", (1,)).fetchone()[0])
    with conn:
        conn.execute("DELETE FROM esperimenti WHERE id=?", (1,))
print("Residui:", conn.execute("SELECT COUNT(*) FROM esperimenti").fetchone()[0])Creati: 1 Stato: completato Residui: 0
Interpretazione: l’identificativo non cambia durante UPDATE; DELETE elimina il record ma non la struttura. Casi limite: titoli vuoti, stati non ammessi e record assenti. In una versione più rigorosa prevedere CHECK(stato IN (...)).
Esperimento C — Dal CSV al database
Problema: importare tre righe CSV, scartando una misura non numerica. Dati iniziali: 19,5; «errore»; 21,5 °C. Algoritmo: leggere con csv.DictReader, validare, accumulare righe valide, usare executemany(), confrontare i risultati.
import csv, io, sqlite3
from contextlib import closing
origine = io.StringIO("giorno,gradi\n2026-11-10,19.5\n2026-11-11,errore\n2026-11-12,21.5\n")
validi, scartati = [], 0
for r in csv.DictReader(origine):
    try:
        valore = float(r["gradi"])
        if not -273.15 <= valore <= 1000:
            raise ValueError("Temperatura fuori intervallo")
        validi.append((r["giorno"], valore))
    except (ValueError, TypeError):
        scartati += 1
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE temperature (giorno TEXT, gradi REAL)")
        conn.executemany("INSERT INTO temperature VALUES (?, ?)", validi)
    n, media = conn.execute("SELECT COUNT(*), AVG(gradi) FROM temperature").fetchone()
    print(f"CSV: 3 righe; valide: {len(validi)}; scartate: {scartati}")
print(f"Database: {n} righe; media: {media:.2f} °C")CSV: 3 righe; valide: 2; scartate: 1 Database: 2 righe; media: 20.50 °C
Interpretazione: i dati nel database sono un sottoinsieme validato dell’input; non dobbiamo nascondere gli scarti. Casi limite: intestazioni mancanti, CSV vuoto, separatore diverso, codifica e valori non finiti (nan, inf); il programma scaricabile esegue controlli ulteriori.
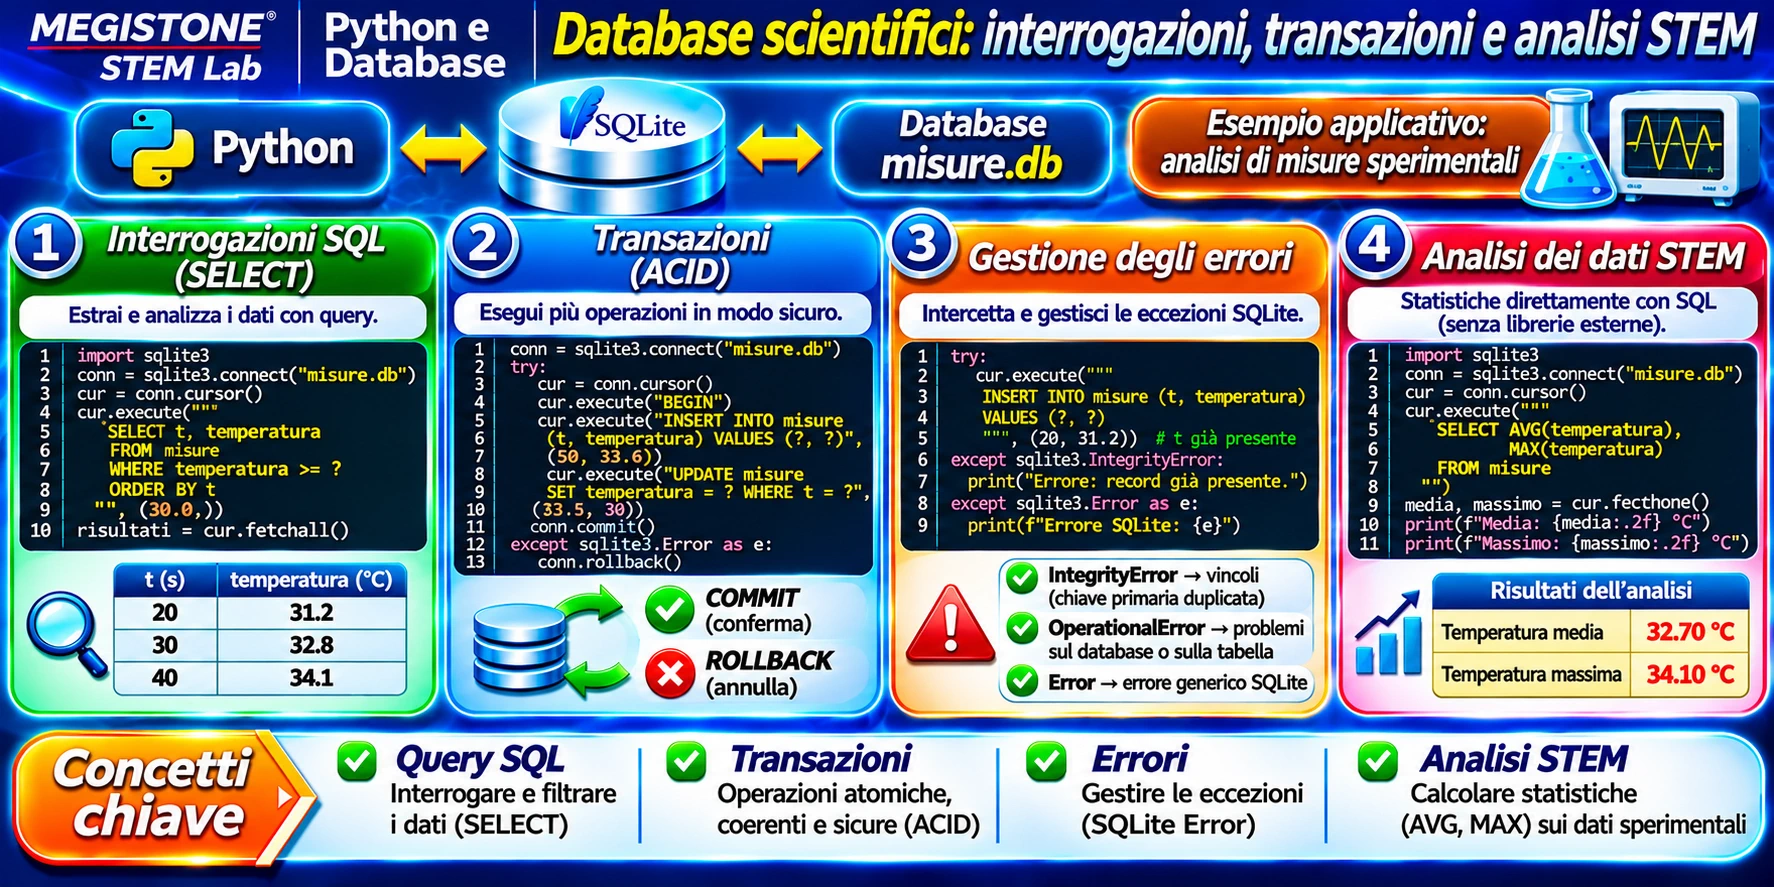
15.17 — Progetto Python STEM scaricabile
MEGI — Gestore di database scientifici Python è un’applicazione da terminale che usa esclusivamente librerie standard e un database SQLite in una sottocartella dati. Le funzioni sono separate: inizializzazione, inserimento, ricerca, aggiornamento, eliminazione con conferma, analisi statistica, importazione CSV e dati campione.
Avvia il file MEGI_Gestore_Database_Scientifici.py con IDLE (F5) o da VS Code/terminale con python MEGI_Gestore_Database_Scientifici.py. Seleziona 1 per caricare i tre campioni, 3 per leggerli e 7 per ottenere media/min/max. Il caricamento dei campioni funziona soltanto quando la tabella è vuota: non sovrascrive registrazioni esistenti.

Programma Python autonomo con SQLite, esempi scientifici e README.
1 Campioni | 2 Inserisci | 3 Elenca | 4 Cerca | 5 Aggiorna | 6 Elimina | 7 Analisi | 8 Importa CSV | 0 Esci
Scelta: 1
Campioni caricati: 3
Scelta: 7
Grandezza (vuoto = tutte): Temperatura
N=3; media=20.33; min=19.50; max=21.50
Il pacchetto ZIP scaricabile contiene il programma Python autonomo, un database SQLite di esempio, un file CSV con dati campione e il README con le istruzioni per l’esecuzione.
Il progetto utilizza esclusivamente librerie standard di Python e non richiede MySQL.
15.18 — Allenati con MEGI — 20 esercizi progressivi
Gli esercizi sono ordinati in cinque livelli (A–E), quattro per ciascuno. Ogni soluzione è nascosta inizialmente e si apre individualmente per l’autocorrezione. Negli esercizi 13–17 il codice Python 3.13 è autonomo e usa database SQLite temporanei: non modifica archivi personali.
Livello A — Comprensione
Esercizio 01 — Spiega quando preferire CSV a SQLite.
Obiettivo: Spiega quando preferire CSV a SQLite.
Traccia: Raffronta esportazione semplice e aggiornamento selettivo.
Mostra soluzione commentata — esercizio 01
CSV è ottimo per scambiare una tabella piatta; SQLite è adatto a interrogazioni e aggiornamenti ripetuti con transazioni.
Risultato atteso: Distinguere esigenze, non affermare che uno sia sempre superiore.
Esercizio 02 — Distingui database, DBMS e applicazione.
Obiettivo: Distingui database, DBMS e applicazione.
Traccia: Definisci i tre termini in una frase ciascuno.
Mostra soluzione commentata — esercizio 02
Database: insieme organizzato dei dati; DBMS: sistema di gestione; applicazione Python: programma che li utilizza.
Risultato atteso: Tre ruoli distinti.
Esercizio 03 — Chiave primaria e NULL.
Obiettivo: Chiave primaria e NULL.
Traccia: Perché servono? NULL equivale a zero?
Mostra soluzione commentata — esercizio 03
Una chiave primaria distingue record; NULL denota un valore mancante/sconosciuto, non zero.
Risultato atteso: Mai confrontare NULL con = NULL.
Esercizio 04 — Descrivi CRUD.
Obiettivo: Descrivi CRUD.
Traccia: Collega le quattro lettere alle istruzioni più comuni.
Mostra soluzione commentata — esercizio 04
Create → INSERT; Read → SELECT; Update → UPDATE; Delete → DELETE.
Risultato atteso: CREATE TABLE definisce la struttura, non è la C operativa di CRUD.
Livello B — Lettura e tracciamento
Esercizio 05 — Conta i risultati di una SELECT.
Obiettivo: Conta i risultati di una SELECT.
Traccia: Dati 10, 15, 20: quante righe soddisfano valore > 12?
Mostra soluzione commentata — esercizio 05
Due righe: 15 e 20.
Risultato atteso: 2
Esercizio 06 — Comprendi fetchone().
Obiettivo: Comprendi fetchone().
Traccia: Cosa restituisce una SELECT senza risultati?
Mostra soluzione commentata — esercizio 06
fetchone() restituisce None; fetchall() restituisce [].
Risultato atteso: None oppure [] secondo il metodo.
Esercizio 07 — Prevedi rowcount.
Obiettivo: Prevedi rowcount.
Traccia: UPDATE di id=99 su tabella che contiene soltanto id=1 e id=2.
Mostra soluzione commentata — esercizio 07
rowcount sarà 0 perché nessun record corrisponde.
Risultato atteso: 0
Esercizio 08 — Prevedi AVG().
Obiettivo: Prevedi AVG().
Traccia: Tre valori 19.5, 20.0, 21.5: quale media?
Mostra soluzione commentata — esercizio 08
(19.5+20.0+21.5)/3 = 20.333…, mostrata come 20.33.
Risultato atteso: 20.33
Livello C — Debugging
Esercizio 09 — Correggi il parametro singolo.
Obiettivo: Correggi il parametro singolo.
Traccia: Trova l’errore in conn.execute(“SELECT * FROM t WHERE id=?”, (5)).
Mostra soluzione commentata — esercizio 09
Usa (5,) invece di (5): la virgola forma una tupla singola.
Risultato atteso: (5,)
Esercizio 10 — Correggi NULL.
Obiettivo: Correggi NULL.
Traccia: Perché WHERE nota = NULL non trova dati mancanti?
Mostra soluzione commentata — esercizio 10
Perché SQL usa una logica a tre valori: la verifica corretta è WHERE nota IS NULL.
Risultato atteso: IS NULL
Esercizio 11 — Proteggi una query.
Obiettivo: Proteggi una query.
Traccia: Sostituisci una query costruita concatenando una variabile.
Mostra soluzione commentata — esercizio 11
conn.execute(“SELECT * FROM t WHERE nome=?”, (nome,)) mantiene separati dati e SQL.
Risultato atteso: Placeholder ?
Esercizio 12 — Correggi il ciclo di vita.
Obiettivo: Correggi il ciclo di vita.
Traccia: Perché with sqlite3.connect(…) non assicura la chiusura?
Mostra soluzione commentata — esercizio 12
Il context manager della connessione gestisce commit/rollback. Usa contextlib.closing oppure conn.close() in finally.
Risultato atteso: Chiusura esplicita
Livello D — Programmazione SQLite
Esercizio 13 — Crea una tabella di misure.
Obiettivo: Crea una tabella di misure.
Traccia: Scrivi SQL per id intero primario e valore REAL obbligatorio.
Mostra soluzione commentata — esercizio 13
Soluzione Python 3.13 completa ed eseguibile (database di prova in memoria):
import sqlite3
from contextlib import closing

# Database isolato: nessun file personale modificato.
with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("""CREATE TABLE misure (
            id INTEGER PRIMARY KEY,
            valore REAL NOT NULL
        )""")
    presente = conn.execute("""SELECT name FROM sqlite_master
        WHERE type = 'table' AND name = ?""", ("misure",)).fetchone()
    print("Tabella creata:", presente[0])
Spiegazione: La definizione SQL è eseguita da Python; `PRIMARY KEY` identifica ogni riga e `NOT NULL` rende obbligatorio il valore.
Tabella creata: misure
Esercizio 14 — Inserisci con parametri.
Obiettivo: Inserisci con parametri.
Traccia: Prepara una INSERT sicura per 18.75.
Mostra soluzione commentata — esercizio 14
Soluzione Python 3.13 completa ed eseguibile (database di prova in memoria):
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL NOT NULL)")
        cursor = conn.execute(
            "INSERT INTO misure (valore) VALUES (?)", (18.75,)
        )
        identificativo = cursor.lastrowid
    valore = conn.execute(
        "SELECT valore FROM misure WHERE id = ?", (identificativo,)
    ).fetchone()[0]
    print(f"ID={identificativo}; valore={valore:.2f}")
Spiegazione: Il placeholder `?` separa dato e istruzione SQL; `(18.75,)` è una tupla con un solo elemento. Il blocco transazionale conferma l’inserimento.
ID=1; valore=18.75
Esercizio 15 — Ricerca ordinata.
Obiettivo: Ricerca ordinata.
Traccia: Elenca i cinque valori maggiori di 20 in ordine decrescente.
Mostra soluzione commentata — esercizio 15
Soluzione Python 3.13 completa ed eseguibile (database di prova in memoria):
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL NOT NULL)")
        conn.executemany("INSERT INTO misure (valore) VALUES (?)",
                         [(18.0,), (21.5,), (25.0,), (19.0,),
                          (23.0,), (30.0,), (22.0,), (27.0,)])
    righe = conn.execute("""SELECT valore FROM misure
        WHERE valore > ? ORDER BY valore DESC LIMIT 5""", (20.0,)).fetchall()
    print(", ".join(f"{r[0]:.2f}" for r in righe))
Spiegazione: `WHERE` esclude i valori fino a 20 inclusi, `ORDER BY … DESC` ordina dal maggiore e `LIMIT 5` mostra al massimo cinque righe.
30.00, 27.00, 25.00, 23.00, 22.00
Esercizio 16 — Elimina per ID.
Obiettivo: Elimina per ID.
Traccia: Elimina solo il record 3.
Mostra soluzione commentata — esercizio 16
Soluzione Python 3.13 completa ed eseguibile (database di prova in memoria):
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE misure (id INTEGER PRIMARY KEY, valore REAL NOT NULL)")
        conn.executemany("INSERT INTO misure (id, valore) VALUES (?, ?)",
                         [(1, 18.5), (2, 19.5), (3, 20.5)])
    id_da_eliminare = 3  # ID esplicito e preventivamente verificato
    esiste = conn.execute("SELECT 1 FROM misure WHERE id = ?",
                          (id_da_eliminare,)).fetchone() is not None
    eliminate = 0
    if esiste:
        with conn:
            cursor = conn.execute("DELETE FROM misure WHERE id = ?",
                                  (id_da_eliminare,))
            eliminate = cursor.rowcount
    rimaste = conn.execute("SELECT COUNT(*) FROM misure").fetchone()[0]
    print(f"Eliminate={eliminate}; rimaste={rimaste}")
Spiegazione: La cancellazione riguarda soltanto la chiave indicata ed è eseguita in un database temporaneo; si controllano esistenza e `rowcount`.
Eliminate=1; rimaste=2
Livello E — Applicazioni STEM
Esercizio 17 — Media delle temperature.
Obiettivo: Media delle temperature.
Traccia: Leggi media e minimo di una tabella di temperature.
Mostra soluzione commentata — esercizio 17
Soluzione Python 3.13 completa ed eseguibile (database di prova in memoria):
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(":memory:", autocommit=False)) as conn:
    with conn:
        conn.execute("CREATE TABLE temperature (id INTEGER PRIMARY KEY, gradi REAL NOT NULL)")
        conn.executemany("INSERT INTO temperature (gradi) VALUES (?)",
                         [(19.5,), (20.0,), (21.5,)])
    media, minimo = conn.execute(
        "SELECT AVG(gradi), MIN(gradi) FROM temperature"
    ).fetchone()
    if media is None:
        print("Nessuna misura disponibile")
    else:
        print(f"Media={media:.2f} °C; minimo={minimo:.2f} °C")
Spiegazione: `AVG` e `MIN` restituiscono valori aggregati; su tabella vuota restituiscono `NULL` (in Python `None`), perciò il controllo è necessario prima della formattazione.
Media=20.33 °C; minimo=19.50 °C
Esercizio 18 — CSV con errore.
Obiettivo: CSV con errore.
Traccia: Un CSV contiene 19.5, x, 21.5: quante righe importi?
Mostra soluzione commentata — esercizio 18
Due valide, una scartata; media delle valide 20.50.
Risultato atteso: 2 valide; 1 scartata
Esercizio 19 — Controllo dei vincoli.
Obiettivo: Controllo dei vincoli.
Traccia: Una temperatura inferiore a -273.15 °C deve essere accettata?
Mostra soluzione commentata — esercizio 19
No: prevedi validazione applicativa e un CHECK coerente con il modello fisico.
Risultato atteso: Record rifiutato
Esercizio 20 — Transazione sicura.
Obiettivo: Transazione sicura.
Traccia: Due INSERT, la seconda viola UNIQUE: cosa accade con with conn e autocommit=False?
Mostra soluzione commentata — esercizio 20
Entrambe le modifiche della transazione vengono annullate se l’eccezione esce dal blocco with conn.
Risultato atteso: 0 nuove righe
Collegamenti e documentazione
Per ripassare: B1.05 — Collezioni Python e B1.06 — File Python e percorsi.
Documentazione tecnica: Python 3.13 — sqlite3; SQLite — Datatypes; MySQL Connector/Python.
Il pulsante arancione per il futuro MEGISTONE STEM LAB B1.07 andrà inserito soltanto dopo la pubblicazione e il collaudo del laboratorio. Analogamente, il pulsante download ZIP sarà collegato all’URL definitivo solo dopo l’upload.