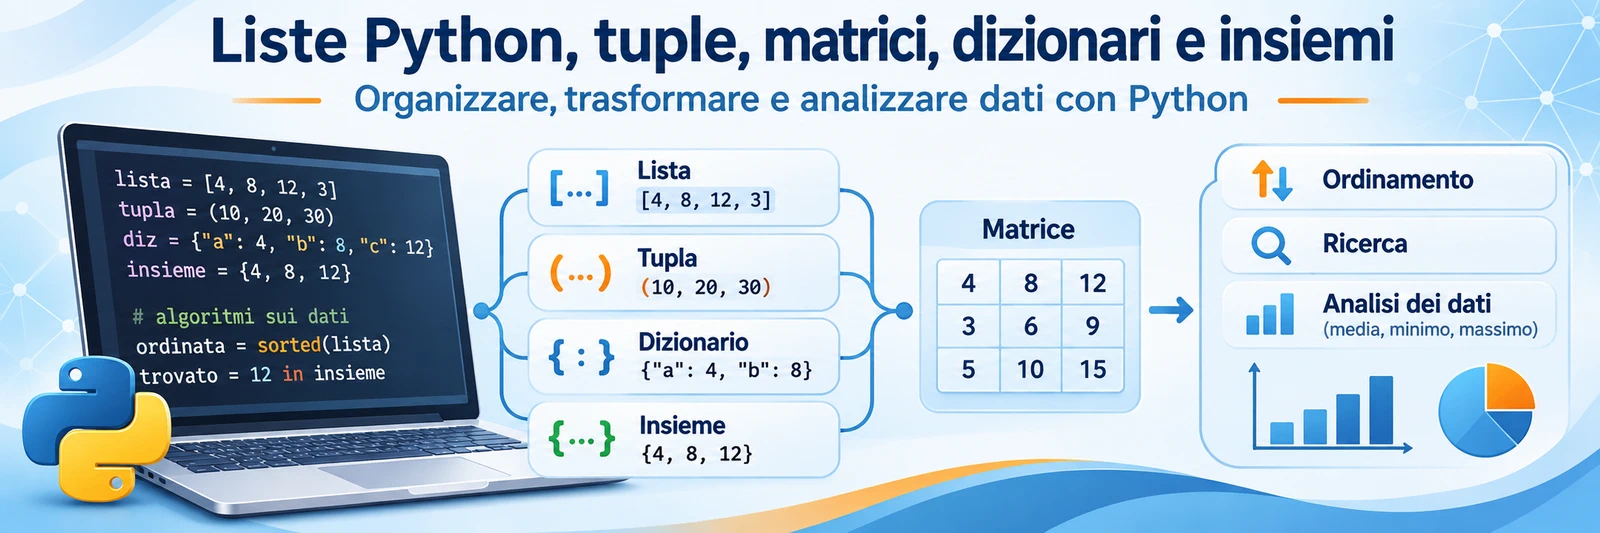
Liste Python, tuple, matrici, dizionari e insiemi permettono di organizzare, trasformare e analizzare dati. In questo capitolo impariamo a scegliere strutture adeguate, a evitare errori di mutabilità e a sviluppare algoritmi verificabili con Python 3.13 e applicazioni STEM.
Prerequisiti: variabili, espressioni, condizioni, cicli, funzioni, parametri, scope, debugging (B1.01–B1.04). Obiettivi: creare e manipolare collezioni, risolvere problemi con ricerca e ordinamento, rappresentare matrici, calcolare statistiche descrittive, documentare e testare funzioni. Perimetro: non sono trattati qui lettura di file, database e programmazione a oggetti.
Ripasso consigliato: Python: funzioni, parametri, moduli e ricorsione.
13.1 — Le strutture dati in Python
Una variabile può rappresentare un singolo valore, ma una rilevazione scientifica produce spesso molti valori collegati: temperature nel tempo, voti, coordinate, categorie. Una struttura dati permette di organizzarli e di applicare algoritmi in modo sistematico. In Python le liste e le tuple sono sequenze, i dizionari associano chiavi a valori e gli insiemi modellano collezioni di elementi distinti.
Per scegliere una struttura considera quattro domande: conta l’ordine? I valori possono ripetersi? Dovranno cambiare? Serve recuperare un valore mediante un indice oppure una chiave? Per esempio una serie temporale richiede generalmente una lista; le coordinate fisse possono essere una tupla; una scheda di laboratorio può essere un dizionario; le categorie osservate senza ripetizioni un insieme.
temperature = [18.5, 19.0, 18.5]  # lista: duplicati consentiti
punto = (3, 4)                 # tupla
sensore = {"id": "T1", "valore": 18.5}  # dizionario
categorie = {"sole", "pioggia", "sole"}  # insieme
print(len(temperature), punto[0], sensore["id"], len(categorie))3 3 T1 2
13.2 — Le liste Python
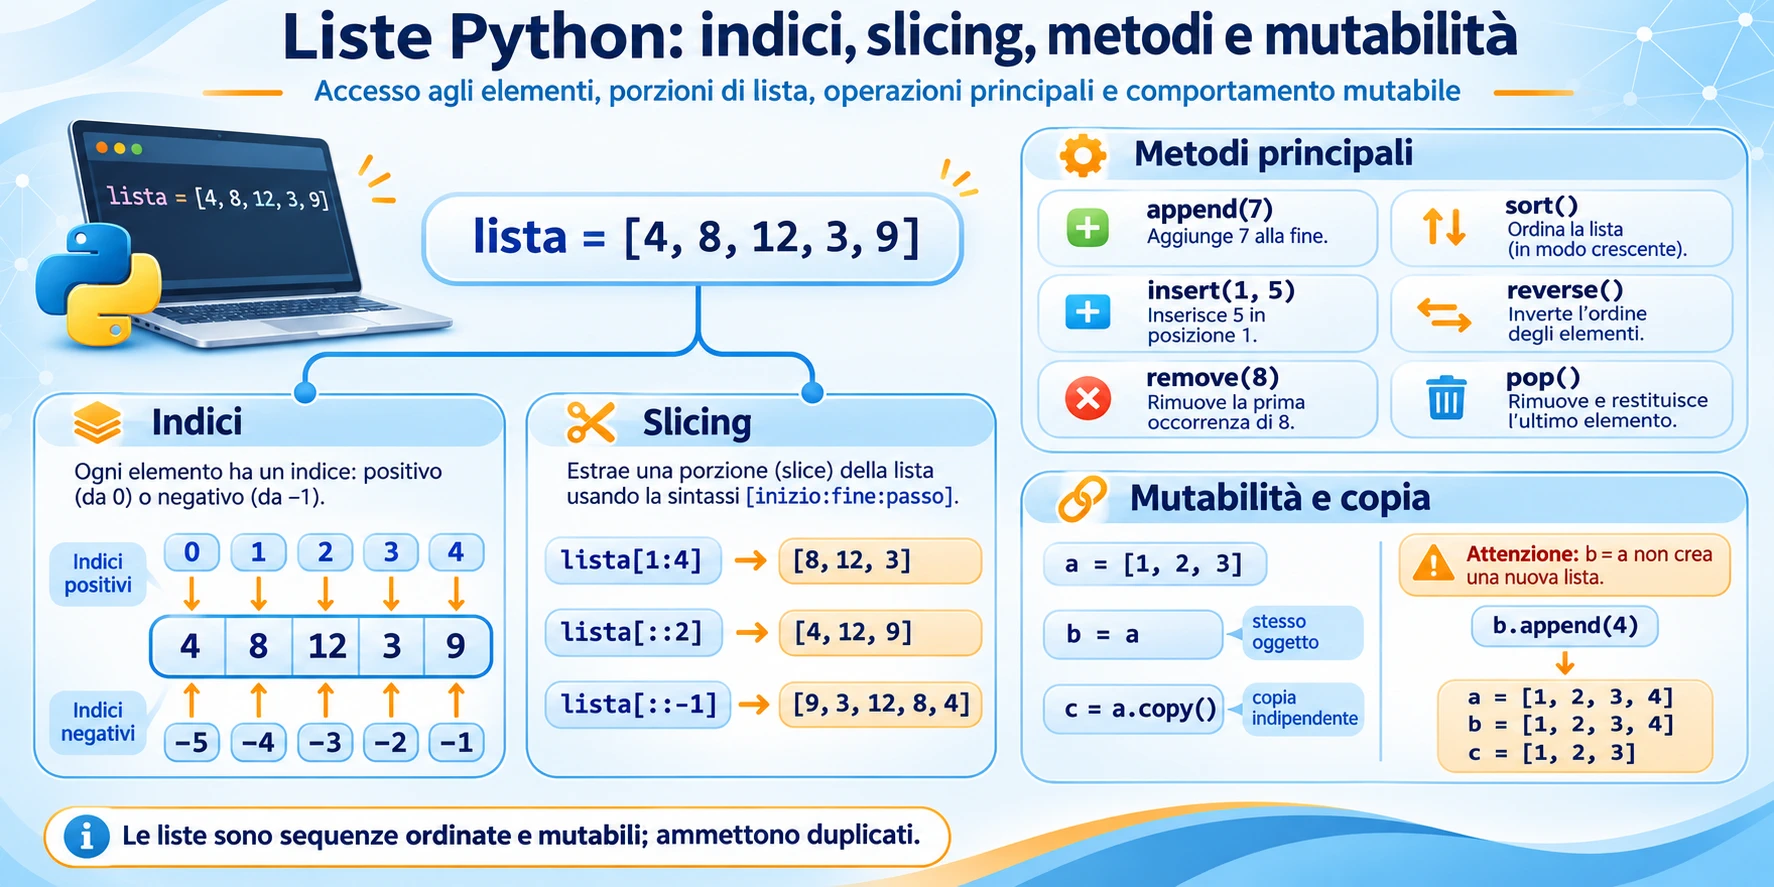
Una lista è una sequenza ordinata e mutabile: mantiene l’ordine degli elementi, ammette duplicati e può essere modificata. Le parentesi quadre delimitano la lista; gli indici partono da 0. Un indice negativo conta dalla fine: -1 seleziona l’ultimo elemento. Le liste possono mescolare tipi, ma in analisi numerica è preferibile mantenere dati omogenei.
misure = [12.4, 13.1, 12.4]
vuota = []
print(misure[0], misure[-1], len(misure))
misure[1] = 13.5
print(misure)
print(12.4 in misure, 20 in misure)12.4 12.4 3 [12.4, 13.5, 12.4] True False
Gli indici inesistenti causano IndexError. Prima di leggere misure[0], controlla che la lista non sia vuota: if misure:.
13.3 — Slicing e attraversamento delle liste
Lo slicing produce una nuova lista con la sintassi lista[start:stop:step]. L’indice start è incluso, stop è escluso, mentre step è il passo e non può valere zero. Se omessi, vengono usati valori predefiniti coerenti con la direzione del passo.
dati = [10, 20, 30, 40, 50]
print(dati[1:4], dati[::2], dati[::-1])
for indice, valore in enumerate(dati):
    print(indice, valore, end="; ")
print()
for i in range(2):
print(dati[i], end=" ")[20, 30, 40] [10, 30, 50] [50, 40, 30, 20, 10] 0 10; 1 20; 2 30; 3 40; 4 50; 10 20
Usa for valore in dati quando ti serve soltanto il valore; enumerate() quando serve anche la posizione. Modificare la lunghezza della lista durante un normale ciclo di attraversamento può portare a saltare elementi.
13.4 — Metodi delle liste
Un metodo è un’operazione richiamata sull’oggetto, per esempio lista.append(5). Alcuni metodi cambiano la lista e restituiscono None, altri forniscono un’informazione senza modificarla. Non confondere lista.sort() (modifica in loco) con sorted(lista) (crea una nuova lista ordinata).
| Metodo | Effetto | Modifica la lista? |
|---|---|---|
append(x) |
Aggiunge un elemento in coda | Sì |
extend(iterabile) |
Aggiunge tutti gli elementi | Sì |
insert(i,x) |
Inserisce nella posizione i | Sì |
remove(x) |
Elimina la prima occorrenza, errore se assente | Sì |
pop(i) |
Rimuove e restituisce l’elemento (di default l’ultimo) | Sì |
clear() |
Svuota | Sì |
index(x) |
Restituisce l’indice della prima occorrenza, errore se assente | No |
count(x) |
Conta occorrenze | No |
reverse() |
Inverte in loco | Sì |
sort() |
Ordina in loco | Sì |
numeri = [3, 1, 3]
numeri.append(2)
numeri.extend([5, 4])
numeri.insert(0, 9)
print(numeri.count(3), numeri.index(5))
numeri.remove(3)
print(numeri.pop(), numeri)
numeri.sort()
print(numeri)
numeri.reverse()
print(numeri)2 5 4 [9, 1, 3, 2, 5] [1, 2, 3, 5, 9] [9, 5, 3, 2, 1]
13.5 — Copia, riferimenti e mutabilità
Le variabili Python contengono riferimenti a oggetti. L’istruzione b = a non copia gli elementi: entrambi i nomi si riferiscono alla stessa lista. L’operatore == confronta i valori, mentre is confronta l’identità dell’oggetto. Una copia superficiale duplica la lista esterna, ma non gli oggetti mutabili annidati; una copia profonda duplica ricorsivamente gli oggetti annidati secondo le regole di copy.deepcopy().
a = [1, 2]
b = a
b.append(3)
print(a, a is b)
c = a.copy()
c.append(4)
print(a, c, a == c, a is c)[1, 2, 3] True [1, 2, 3] [1, 2, 3, 4] False False
from copy import deepcopy
originale = [[1], [2]]
superficiale = originale.copy()
profonda = deepcopy(originale)
originale[0].append(99)
print(superficiale)
print(profonda)[[1, 99], [2]] [[1], [2]]
Se una funzione esegue lista.append(...) sull’argomento ricevuto, può modificare la lista del chiamante: è un effetto collaterale. Se non desiderato, lavora su una copia o costruisci e restituisci una nuova lista.
13.6 — Le tuple
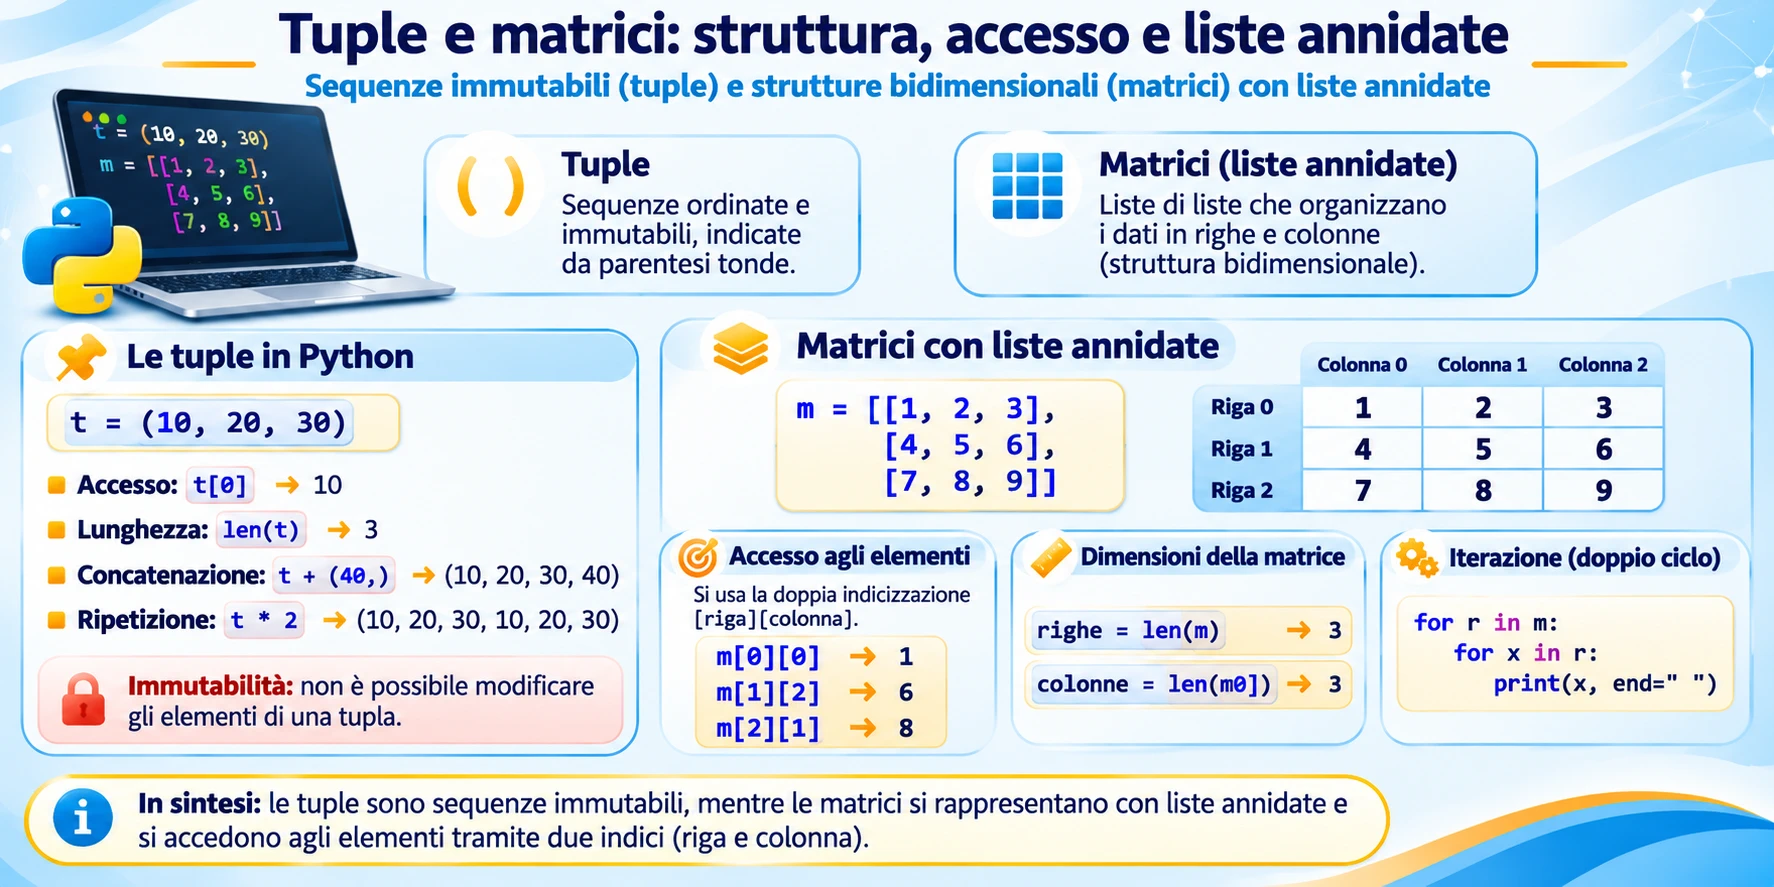
Una tupla è una sequenza ordinata e immutabile: dopo la creazione non se ne possono sostituire o eliminare gli elementi. Supporta indici, slicing, len(), packing e unpacking. Per creare una tupla con un solo elemento è indispensabile la virgola: (7,). La semplice parentesi (7) rappresenta invece un intero.
coordinate = (4, 7)
x, y = coordinate
print(x, y, coordinate[-1], coordinate[:1])
def estremi(valori):
    return min(valori), max(valori)
print(estremi([5, 2, 8]))
print(type((7,)).__name__, type((7)).__name__)4 7 7 (4,) (2, 8) tuple int
L’immutabilità della tupla riguarda i suoi riferimenti: una lista contenuta in una tupla resta mutabile, quindi ([1, 2],)[0].append(3) è consentito. Le tuple sono utili per coordinate e risultati composti da più valori.
13.7 — Le matrici mediante liste annidate
Una matrice rettangolare è una tabella con righe e colonne. In Python, senza librerie esterne, si rappresenta come lista di liste: m[i][j] individua la riga i e la colonna j. Per sommare gli elementi si usano due cicli, oppure una somma di somme. Le medie per colonna richiedono di mantenere fisso l’indice della colonna e attraversare le righe.
m = [[1, 2, 3], [4, 5, 6]]
print(m[1][2])
print(sum(sum(riga) for riga in m))
print([sum(riga) for riga in m])
print([sum(m[i][j] for i in range(len(m)))
for j in range(len(m[0]))])6 21 [6, 15] [5, 7, 9]
Errore da evitare: [[0] * 3] * 3 crea tre riferimenti alla medesima riga: cambiare una cella può alterare più righe. Usa una comprehension che costruisca ogni riga in modo indipendente.
errata = [[0] * 3] * 3
errata[0][1] = 7
print(errata)
corretta = [[0] * 3 for _ in range(3)]
corretta[0][1] = 7
print(corretta)
quadrata = [[1, 2], [3, 4]]
print(sum(quadrata[i][i] for i in range(len(quadrata))))[[0, 7, 0], [0, 7, 0], [0, 7, 0]] [[0, 7, 0], [0, 0, 0], [0, 0, 0]] 5
L’estrazione della diagonale principale vale per matrici quadrate. Prima di elaborare una matrice esterna, controlla che contenga righe non vuote e tutte della stessa lunghezza.
Una matrice rettangolare di dimensioni r × c contiene r righe e c colonne. Un attraversamento completo con due cicli annidati visita r × c celle: per esempio, per ogni riga si legge ciascun valore e si accumula la somma. Gli accessi m[i][j] richiedono indici validi, con 0 ≤ i < r e 0 ≤ j < c.
13.8 — Algoritmi sulle liste
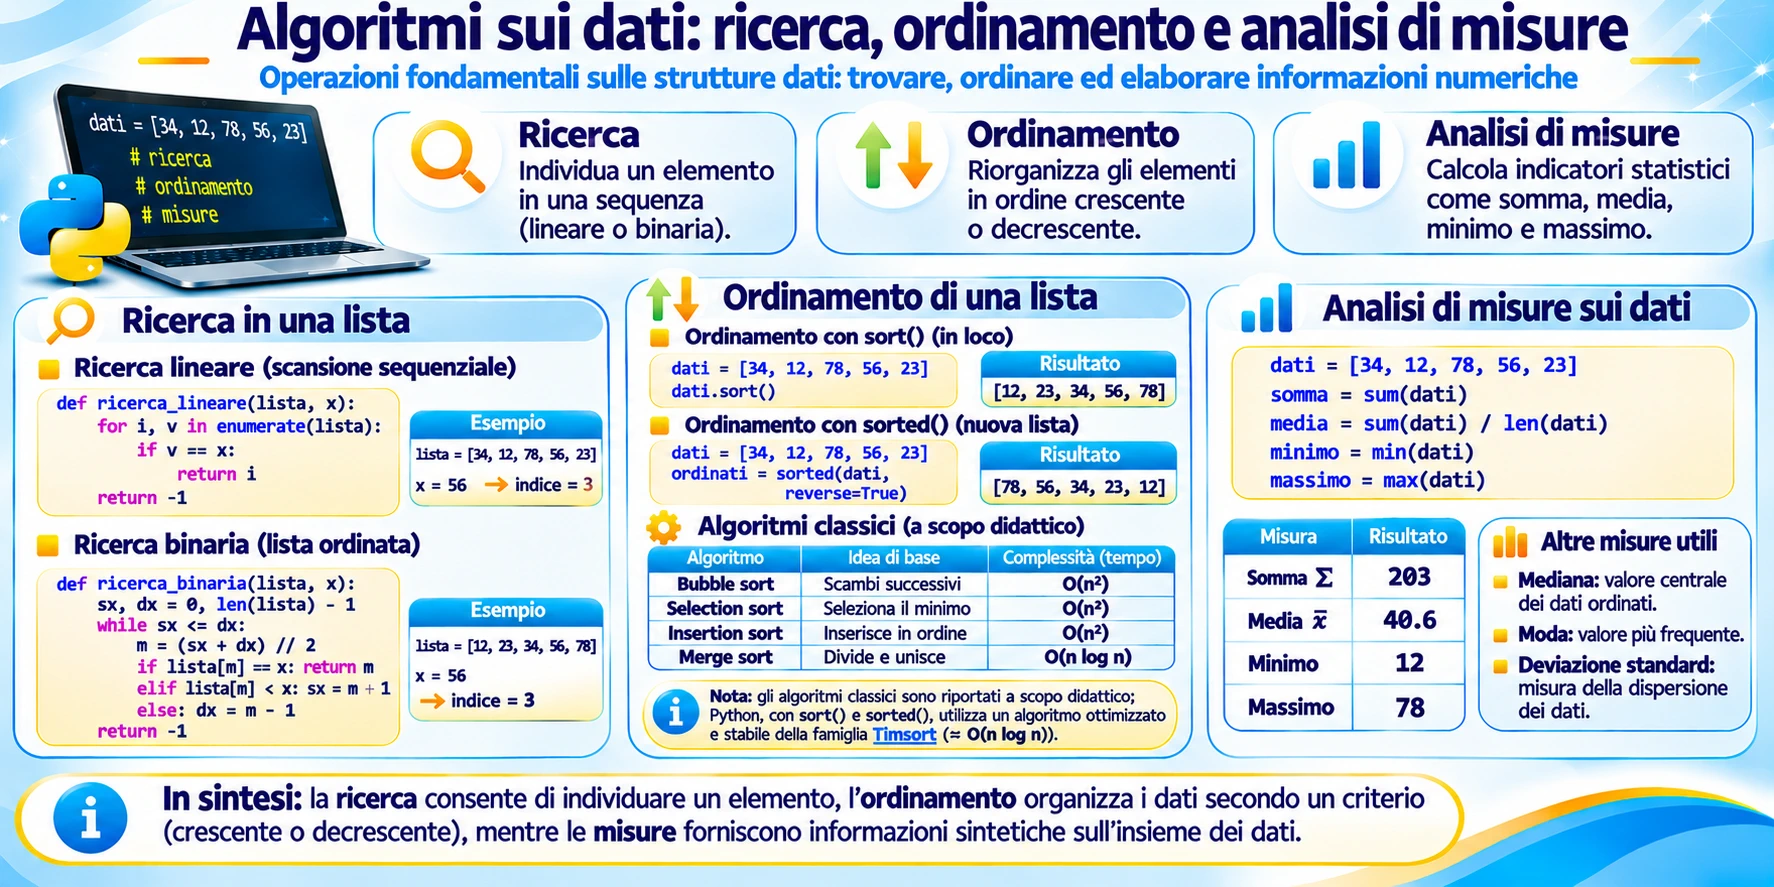
Un algoritmo è una sequenza finita di operazioni ben definite, mentre sum(), min() e max() sono funzioni integrate che risolvono operazioni frequenti. Una ricerca sequenziale controlla ogni elemento fino al primo risultato o fino al termine della lista. La media aritmetica richiede n > 0; il calcolo deve gestire esplicitamente il caso vuoto.
def media(valori):
    if not valori:
        raise ValueError("Lista vuota")
    return sum(valori) / len(valori)

def cerca(valori, bersaglio):
    for posizione, valore in enumerate(valori):
        if valore == bersaglio:
            return posizione
    return -1

misure = [11, 13, 12, 13]
print(f"{media(misure):.2f}", cerca(misure, 12))
print(sum(v > 12 for v in misure))
print([v for v in misure if v >= 12])12.25 2 2 [13, 12, 13]
Per il minimo e il massimo su una lista vuota, Python solleva ValueError; è corretto controllare i dati oppure utilizzare il parametro default quando esiste un valore sensato per il problema.
13.9 — Ordinamento e ricerca binaria
L’ordinamento dispone i dati secondo un criterio. sorted() restituisce una nuova lista; sort() modifica l’originale. Entrambi ammettono reverse=True e key per definire il criterio. La ricerca lineare funziona anche con dati disordinati e nel caso peggiore esamina tutti gli n elementi: costo O(n). La ricerca binaria, invece, richiede dati già ordinati e dimezza progressivamente l’intervallo: costo O(log n) della sola ricerca; ordinare prima ha un costo aggiuntivo.
parole = ["sole", "pioggia", "vento"]
print(sorted(parole, key=len))
numeri = [7, 1, 4, 9, 3]
ordinati = sorted(numeri)
def binaria(a, valore):
    sinistra, destra = 0, len(a) - 1
    while sinistra <= destra:
        centro = (sinistra + destra) // 2
        if a[centro] == valore:
            return centro
        if a[centro] < valore:
            sinistra = centro + 1
        else:
            destra = centro - 1
    return -1
print(ordinati, binaria(ordinati, 7), binaria(ordinati, 8))['sole', 'vento', 'pioggia'] [1, 3, 4, 7, 9] 3 -1
Traccia della ricerca di 7 in [1, 3, 4, 7, 9]: prima esamina l’indice 2 (valore 4); restringe agli indici 3–4; poi trova 7 all’indice 3. Se i dati non sono ordinati, il risultato non è affidabile.
Per un elenco già ordinato, la ricerca binaria richiede al più un numero di confronti proporzionale a log₂(n). Se devi effettuare una sola ricerca su dati disordinati, non è detto che ordinarli prima sia vantaggioso. Questa implementazione restituisce un indice corrispondente al valore, non necessariamente la prima occorrenza in presenza di duplicati.
13.10 — List comprehension
Una list comprehension esprime in forma compatta la costruzione di una lista: [espressione for elemento in sequenza if condizione]. Può trasformare oppure filtrare i dati. Non è necessario usarla a ogni costo: quando la logica comprende più passaggi, un normale ciclo for è spesso più facile da leggere e verificare.
valori = [1, 2, 3, 4, 5]
quadrati = [x * x for x in valori]
pari = [x for x in valori if x % 2 == 0]
tradizionale = []
for x in valori:
    if x % 2 == 0:
        tradizionale.append(x)
print(quadrati, pari, tradizionale)[1, 4, 9, 16, 25] [2, 4] [2, 4]
13.11 — Dizionari Python
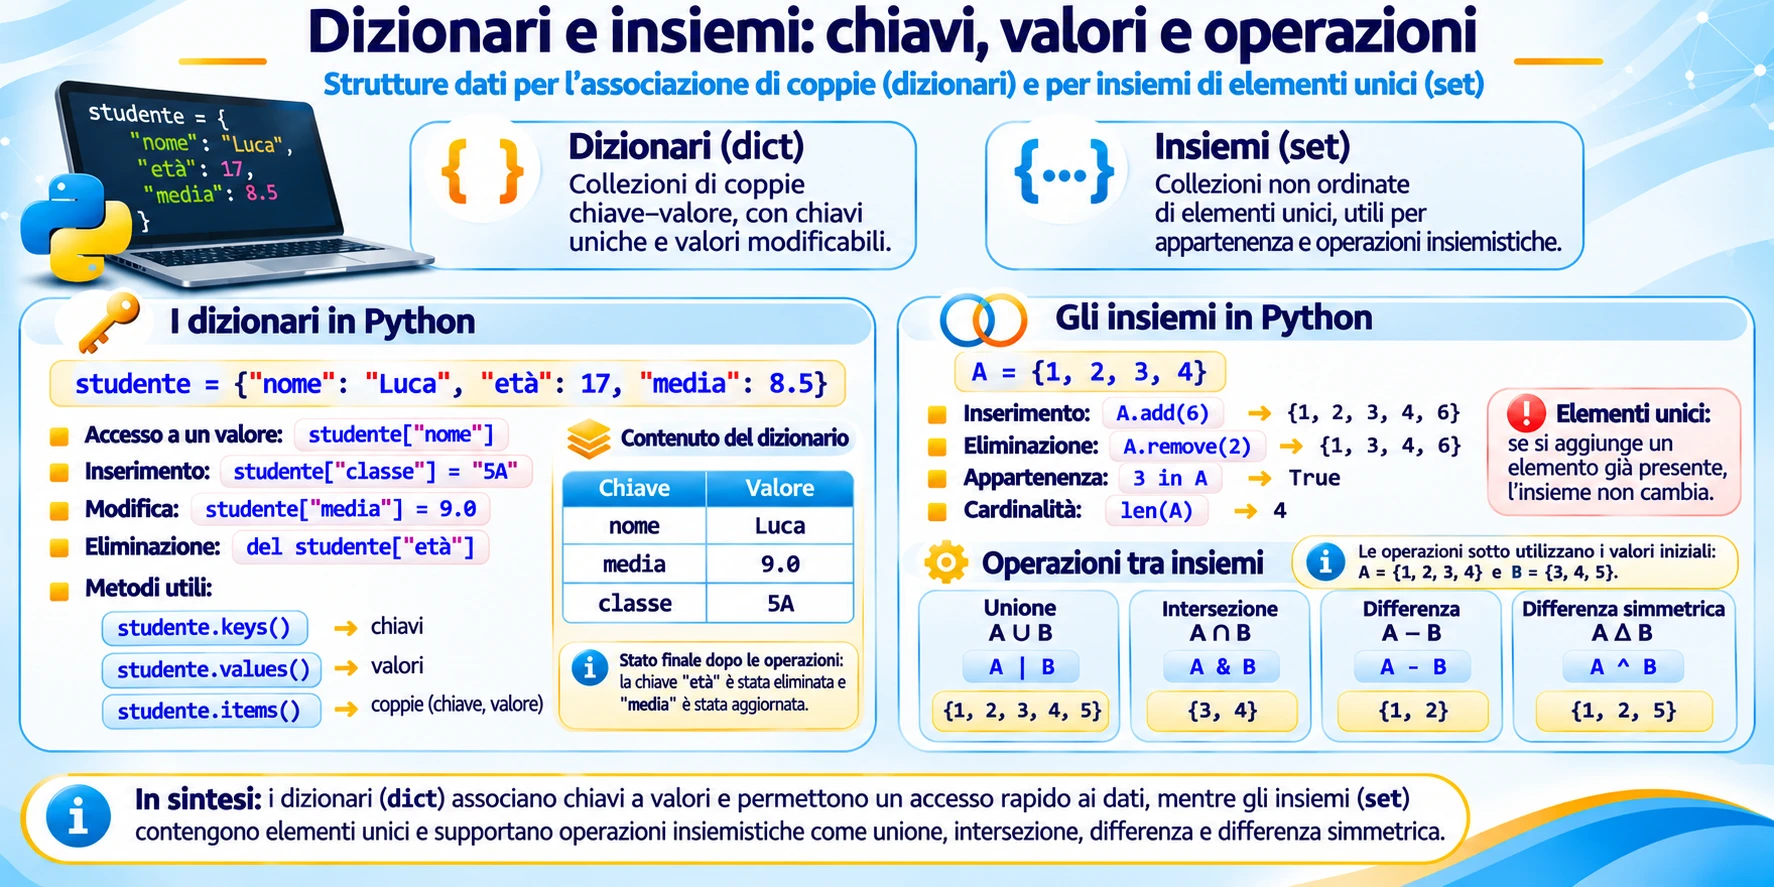
Un dizionario (dict) associa chiavi a valori. Le chiavi devono essere hashable, cioè possedere un valore hash stabile per la loro durata come chiavi: stringhe, interi e tuple di elementi hashable sono esempi comuni; le liste non lo sono. Le chiavi sono uniche; assegnare una chiave già presente ne aggiorna il valore. In Python moderno, il dizionario mantiene l’ordine di inserimento, ma l’accesso tipico avviene per chiave, non per indice numerico.
campione = {"id": "A1", "massa": 12.5}
campione["massa"] = 12.8
campione["unita"] = "g"
print(campione.get("temperatura", "non rilevata"))
print(list(campione.keys()))
print(list(campione.values()))
for chiave, valore in campione.items():
    print(chiave, valore)
del campione["unita"]non rilevata ['id', 'massa', 'unita'] ['A1', 12.8, 'g'] id A1 massa 12.8 unita g
L’accesso con d[chiave] solleva KeyError se la chiave manca; d.get(chiave, default) consente invece un valore sostitutivo. keys(), values() e items() restituiscono viste dinamiche del contenuto.
13.12 — Dizionari e algoritmi sui dati
Per contare le frequenze, visita ogni osservazione e aumenta il contatore associato alla categoria. get() semplifica la gestione della prima comparsa; il risultato conserva l’ordine della prima apparizione delle chiavi. Nelle analisi su dati inseriti dall’utente conviene normalizzare le etichette, per esempio con strip().lower(), e rifiutare categorie vuote.
osservazioni = ["sole", "vento", "sole", "pioggia", "vento", "sole"]
frequenze = {}
for categoria in osservazioni:
    frequenze[categoria] = frequenze.get(categoria, 0) + 1
print(frequenze)
print(max(frequenze, key=frequenze.get)){'sole': 3, 'vento': 2, 'pioggia': 1}
sole
Una scheda scientifica può essere {"id": "P1", "misure": [12.0, 12.5]}: il dizionario descrive campi con nomi significativi, mentre la lista associata raccoglie osservazioni. Non confondere questa struttura con un database: le basi di dati saranno affrontate in B1.07.
13.13 — Gli insiemi Python
Un insieme (set) contiene elementi unici e hashable. L’ordine di iterazione non è garantito e non esistono indici come insieme[0]. Per creare l’insieme vuoto si scrive set(); {} crea invece un dizionario vuoto. Le operazioni di unione, intersezione, differenza e differenza simmetrica sono utili per confrontare categorie di due esperimenti.
a = {"rosso", "verde", "blu"}
b = {"blu", "giallo"}
print(sorted(a | b))
print(sorted(a & b))
print(sorted(a - b))
print(sorted(a ^ b))
a.add("bianco")
a.discard("assente")  # nessun errore se manca
print("bianco" in a)['blu', 'giallo', 'rosso', 'verde'] ['blu'] ['rosso', 'verde'] ['giallo', 'rosso', 'verde'] True
remove(x) solleva KeyError se l’elemento manca, mentre discard(x) non solleva errori in quel caso. Per mostrare un insieme in ordine riproducibile, trasforma il risultato con sorted().
Esempio di eliminazione: s = {“A”, “B”}; s.remove(“A”) lascia {“B”}; s.clear() su un insieme non è trattato qui. Per remove(“C”) si ottiene KeyError, mentre discard(“C”) non produce errore.
13.14 — Confronto tra strutture dati
| Struttura | Ordine | Mutabilità | Duplicati | Accesso |
|---|---|---|---|---|
| Lista | Sì | Mutabile | Ammessi | Indice |
| Tupla | Sì | Immutabile | Ammessi | Indice |
| Dizionario | Inserimento | Mutabile | Chiavi uniche; valori ripetibili | Chiave |
| Insieme | Non garantito | Mutabile | Non ammessi | Appartenenza |
Scegli una lista per serie di misure modificabili; una tupla per coordinate e valori che non devono essere riassegnati; un dizionario per schede e conteggi per categoria; un insieme per eliminare duplicati o confrontare gruppi. Nessuna struttura è “migliore” in assoluto: la correttezza dipende dall’uso.
13.15 — Funzioni e collezioni
Il capitolo precedente ha introdotto parametri, scope, return e moduli. Con le collezioni questi concetti diventano essenziali: una funzione può ricevere una lista e restituire una tupla, oppure produrre un dizionario riepilogativo. Una docstring documenta lo scopo della funzione; annotazioni come list[float] aiutano a comprendere il contratto, ma non impongono automaticamente controlli dei tipi durante l’esecuzione.
Nota: nel caso di una funzione che legge soltanto la lista, la copia non è necessaria. La copia difensiva è utile quando la funzione intende modificare una collezione senza alterare l’originale; una copia superficiale non isola gli oggetti mutabili annidati.
def statistiche(valori: list[float]) -> dict[str, float]:
    """Calcola media ed estremi senza modificare la lista iniziale."""
    if not valori:
        raise ValueError("Nessuna misura")
    copia = valori.copy()
    return {"media": sum(copia) / len(copia),
            "min": min(copia), "max": max(copia)}

misure = [2.0, 4.0, 6.0]
print(statistiche(misure))
print(misure){'media': 4.0, 'min': 2.0, 'max': 6.0}
[2.0, 4.0, 6.0]
13.16 — Applicazioni STEM
Esperimento A — Analisi di misure fisiche
Problema: quattro letture di lunghezza (cm) sono 12,4; 12,8; 12,5; 12,7. Calcolare media, minimo, massimo e intervallo di variazione. Algoritmo: controllare che la lista non sia vuota, sommare e dividere per il numero di letture, trovare estremi e differenza. Interpretazione: l’intervallo di variazione descrive la distanza tra massimo e minimo, non è una stima completa dell’incertezza sperimentale.
misure = [12.4, 12.8, 12.5, 12.7]
if misure:
    media = sum(misure) / len(misure)
    minimo, massimo = min(misure), max(misure)
    print(f"Media: {media:.2f} cm")
    print(f"Minimo: {minimo:.2f}; massimo: {massimo:.2f}")
print(f"Intervallo: {massimo - minimo:.2f} cm")Media: 12.60 cm Minimo: 12.40; massimo: 12.80 Intervallo: 0.40 cm
Caso limite: con zero misure non si può calcolare la media; con una sola misura l’intervallo è 0,00 cm.
Esperimento B — Matrici e temperature
Problema: tre giornate di temperature (°C), con due rilevazioni ciascuna. Dati: [[18, 22], [19, 23], [17, 21]]. Calcolare medie per giorno (righe) e per orario (colonne), minimo e massimo globali. Algoritmo: verifica della forma rettangolare, somme per riga e per colonna, ricerca degli estremi. Le medie descrivono questi dati e non una temperatura climatica generale.
t = [[18, 22], [19, 23], [17, 21]]
if not t or not t[0] or any(len(r) != len(t[0]) for r in t):
    raise ValueError("La matrice deve essere rettangolare e non vuota")
medie_giorno = [sum(r) / len(r) for r in t]
medie_ora = [sum(t[i][j] for i in range(len(t))) / len(t)
             for j in range(len(t[0]))]
tutti = [v for r in t for v in r]
print([f"{v:.2f}" for v in medie_giorno])
print([f"{v:.2f}" for v in medie_ora])
print(min(tutti), max(tutti))['20.00', '21.00', '19.00'] ['18.00', '22.00'] 17 23
Caso limite: una matrice vuota o con righe di lunghezza diversa deve essere rifiutata prima di effettuare accessi per indice.
Esperimento C — Frequenze e classificazioni
Problema: classificare osservazioni meteorologiche e confrontare le categorie rilevate in due gruppi. Algoritmo: frequenze con dizionario, categorie uniche con set(), confronto tramite intersezione e differenza. L’ordine di visualizzazione degli insiemi viene reso stabile con sorted().
a = ["sole", "vento", "sole", "pioggia"]
b = ["sole", "neve", "vento"]
f = {}
for x in a:
    f[x] = f.get(x, 0) + 1
print(f)
print(sorted(set(a) & set(b)))
print(sorted(set(a) - set(b))){'sole': 2, 'vento': 1, 'pioggia': 1}
['sole', 'vento']
['pioggia']
Caso limite: un elenco senza osservazioni produce un dizionario vuoto; le operazioni insiemistiche restano definite, ma non esiste una categoria più frequente.
Le due cifre decimali negli output sono una scelta di presentazione: non implicano automaticamente che gli strumenti di misura abbiano quella precisione. I dati dell’esempio sono illustrativi, e non bisogna dedurne un’incertezza metrologica non calcolata.
13.17 — Progetto Python STEM scaricabile
Il progetto autonomo MEGI — Analizzatore di dati e collezioni Python integra tre modalità: misure fisiche con liste; temperature con matrici; frequenze e confronti con dizionari e insiemi.
🐍 SCARICA IL PROGETTO PYTHON STEM
Come eseguirlo: estrai l’archivio ZIP; apri il programma con IDLE o Visual Studio Code ed eseguilo con Python 3.
Laboratorio interattivo MEGISTONE: esplora visivamente liste, tuple, matrici, dizionari, insiemi e algoritmi sui dati attraverso cinque modalità interattive A–E. Modifica i parametri, esegui gli algoritmi passo dopo passo e verifica i risultati direttamente nel browser.
🐍 APRI IL LABORATORIO INTERATTIVO
13.18 — Allenati con MEGI — 20 esercizi progressivi
Cinque livelli di difficoltà, quattro esercizi ciascuno. Per ogni esercizio, formula prima una risposta autonoma; poi apri soltanto la soluzione relativa. I risultati numerici con due decimali sono formattazioni, non nuove misure esatte.
Livello A · 1 — Riconosci le strutture
Obiettivo e traccia: Indica la struttura più adatta per: misure nel tempo, coordinate immutabili, scheda con campi nominati, insieme di categorie diverse.
Apri la soluzione commentata
Lista per misure, tupla per coordinate, dizionario per scheda, insieme per categorie uniche.
Livello A · 2 — Indici
Obiettivo e traccia: Data a=[4, 8, 12], trova a[0], a[-1] e len(a).
Apri la soluzione commentata
Risultati: 4, 12, 3. Gli indici iniziano da zero.
Livello A · 3 — Mutabilità
Obiettivo e traccia: Spiega perché b=a non crea una copia indipendente di una lista.
Apri la soluzione commentata
Entrambi i nomi si riferiscono allo stesso oggetto. Per la copia superficiale usa a.copy().
Livello A · 4 — Insiemi
Obiettivo e traccia: Un insieme ammette duplicati? Si può leggere il primo elemento con s[0]?
Apri la soluzione commentata
No: i duplicati vengono eliminati e l’insieme non supporta l’indicizzazione.
Livello B · 5 — Slicing
Obiettivo e traccia: Data a=[2,4,6,8,10], prevedi a[1:4] e a[::-1].
Apri la soluzione commentata
[4,6,8] e [10,8,6,4,2]. L’estremo superiore del primo slice è escluso.
Livello B · 6 — Metodi
Obiettivo e traccia: Prevedi il risultato di a=[1,2]; a.append(3); a.pop(0); print(a).
Apri la soluzione commentata
[2,3], perché pop(0) elimina il primo elemento.
Livello B · 7 — Tuple
Obiettivo e traccia: Quali valori assumono x e y dopo x,y=(5,9)?
Apri la soluzione commentata
x=5 e y=9, grazie all’unpacking.
Livello B · 8 — Dizionari
Obiettivo e traccia: Prevedi d={"a":1}; d["a"]+=2; print(d["a"]).
Apri la soluzione commentata
Il risultato è 3: viene aggiornata la stessa chiave.
Livello C · 9 — Copia errata
Obiettivo e traccia: Correggi b=a se vuoi modificare una lista piatta senza cambiare a.
Apri la soluzione commentata
Usa b=a.copy() oppure b=list(a). Per liste annidate considera deepcopy.
Livello C · 10 — Righe condivise
Obiettivo e traccia: Spiega il difetto di m=[[0]*2]*3 e proponi la correzione.
Apri la soluzione commentata
Le tre righe sono lo stesso oggetto. Correzione: m=[[0]*2 for _ in range(3)].
Livello C · 11 — Sort e None
Obiettivo e traccia: Perché b=a.sort() non contiene la lista ordinata?
Apri la soluzione commentata
sort() modifica la lista sul posto e restituisce None; usa b=sorted(a).
Livello C · 12 — Chiave assente
Obiettivo e traccia: Correggi un accesso rischioso f["vento"] se la chiave potrebbe mancare.
Apri la soluzione commentata
Usa f.get("vento", 0) oppure verifica prima "vento" in f.
Livello D · 13 — Media
Obiettivo e traccia: Scrivi una funzione media(v) che sollevi ValueError per una lista vuota.
Apri la soluzione commentata
def media(v):
    if not v:
        raise ValueError("Lista vuota")
    return sum(v) / len(v)

print(f"{media([2, 4, 6]):.2f}")  # 4.00
Soluzione eseguibile: i controlli gestiscono i casi attesi e i commenti indicano il risultato.
Livello D · 14 — Filtraggio
Obiettivo e traccia: Ottieni i numeri positivi da [-2,0,3,5] con una comprehension.
Apri la soluzione commentata
[x for x in [-2,0,3,5] if x > 0] restituisce [3,5].
Livello D · 15 — Frequenze
Obiettivo e traccia: Conta le occorrenze di ["A","B","A"] con un dizionario.
Apri la soluzione commentata
f = {}
for x in ["A", "B", "A"]:
    f[x] = f.get(x, 0) + 1
print(f)  # {'A': 2, 'B': 1}
Soluzione eseguibile: i controlli gestiscono i casi attesi e i commenti indicano il risultato.
Livello D · 16 — Ricerca
Obiettivo e traccia: Scrivi una ricerca sequenziale che restituisca -1 se il dato manca.
Apri la soluzione commentata
def cerca(a, x):
    for i, v in enumerate(a):
        if v == x:
            return i
    return -1

print(cerca([4, 7, 9], 7))  # 1
print(cerca([4, 7, 9], 8))  # -1
Soluzione eseguibile: i controlli gestiscono i casi attesi e i commenti indicano il risultato.
Livello E · 17 — Sensore
Obiettivo e traccia: Per le misure [10.0,11.0,12.0], calcola media e intervallo di variazione.
Apri la soluzione commentata
Media 11.00; intervallo 2.00. Verifica con sum(v)/len(v) e max(v)-min(v).
Livello E · 18 — Tabella termica
Obiettivo e traccia: Trova la media di ciascuna riga di [[18,20],[20,22]].
Apri la soluzione commentata
Le medie per riga sono 19.00 e 21.00; usa una comprehension su m.
Livello E · 19 — Categorie comuni
Obiettivo e traccia: Trova intersezione tra {"sole","vento"} e {"vento","neve"}.
Apri la soluzione commentata
L’intersezione è {"vento"}; l’operatore è &.
Livello E · 20 — Mini progetto
Obiettivo e traccia: Progetta una funzione che restituisca media, minimo e massimo delle misure e gestisca lista vuota.
Apri la soluzione commentata
def riepilogo(v):
    if not v:
        raise ValueError("Nessuna misura")
    return {"media": sum(v) / len(v),
            "min": min(v), "max": max(v)}

print(riepilogo([2, 4, 6]))
# {'media': 4.0, 'min': 2, 'max': 6}
Soluzione eseguibile: i controlli gestiscono i casi attesi e i commenti indicano il risultato.
Approfondimenti e riferimenti: Python Tutorial — Data Structures; Built-in Types; Modulo copy; Modulo bisect. Gli esempi sono didattici e non sostituiscono analisi metrologiche complete.