Python: file TXT, CSV, JSON, file binari e gestione dei percorsi
Come creare, leggere e proteggere file Python per registrare misure, scambiare tabelle e conservare osservazioni scientifiche. Capitolo completo per Python 3.13, con esempi riproducibili e applicazioni STEM.
Prerequisiti: variabili, condizioni, cicli, funzioni, liste e dizionari. Obiettivi: scegliere formati adeguati, gestire percorsi e codifiche, validare input, produrre report e riconoscere le situazioni in cui è necessario un database.
14.1 — Introduzione alla persistenza dei dati
Una variabile Python conserva un valore durante l'esecuzione del programma: quando il processo termina, quel valore non è automaticamente disponibile al successivo avvio. La RAM è memoria di lavoro volatile; un file scritto su SSD o altro supporto consente di conservare informazioni oltre l'esecuzione, salvo cancellazioni, errori del supporto o altre cause di perdita dei dati. Persistenza non significa backup: per dati importanti servono copie indipendenti.
Un file è una sequenza di byte identificata da un percorso nel file system. I file di testo interpretano i byte attraverso una codifica, i binari richiedono invece un formato e regole interpretative. Un programma STEM può raccogliere misure, archiviare osservazioni, esportare risultati o importare dati di laboratorio.
Il file system organizza i file in directory: nomi ed estensioni aiutano le persone, ma l'estensione non garantisce il formato reale.
Esempio Python 3.13
misure = [18.5, 20.0, 19.5]
print(f"Media temporanea: {sum(misure)/len(misure):.2f} °C")
Output verificato
14.2 — Aprire e chiudere un file in Python
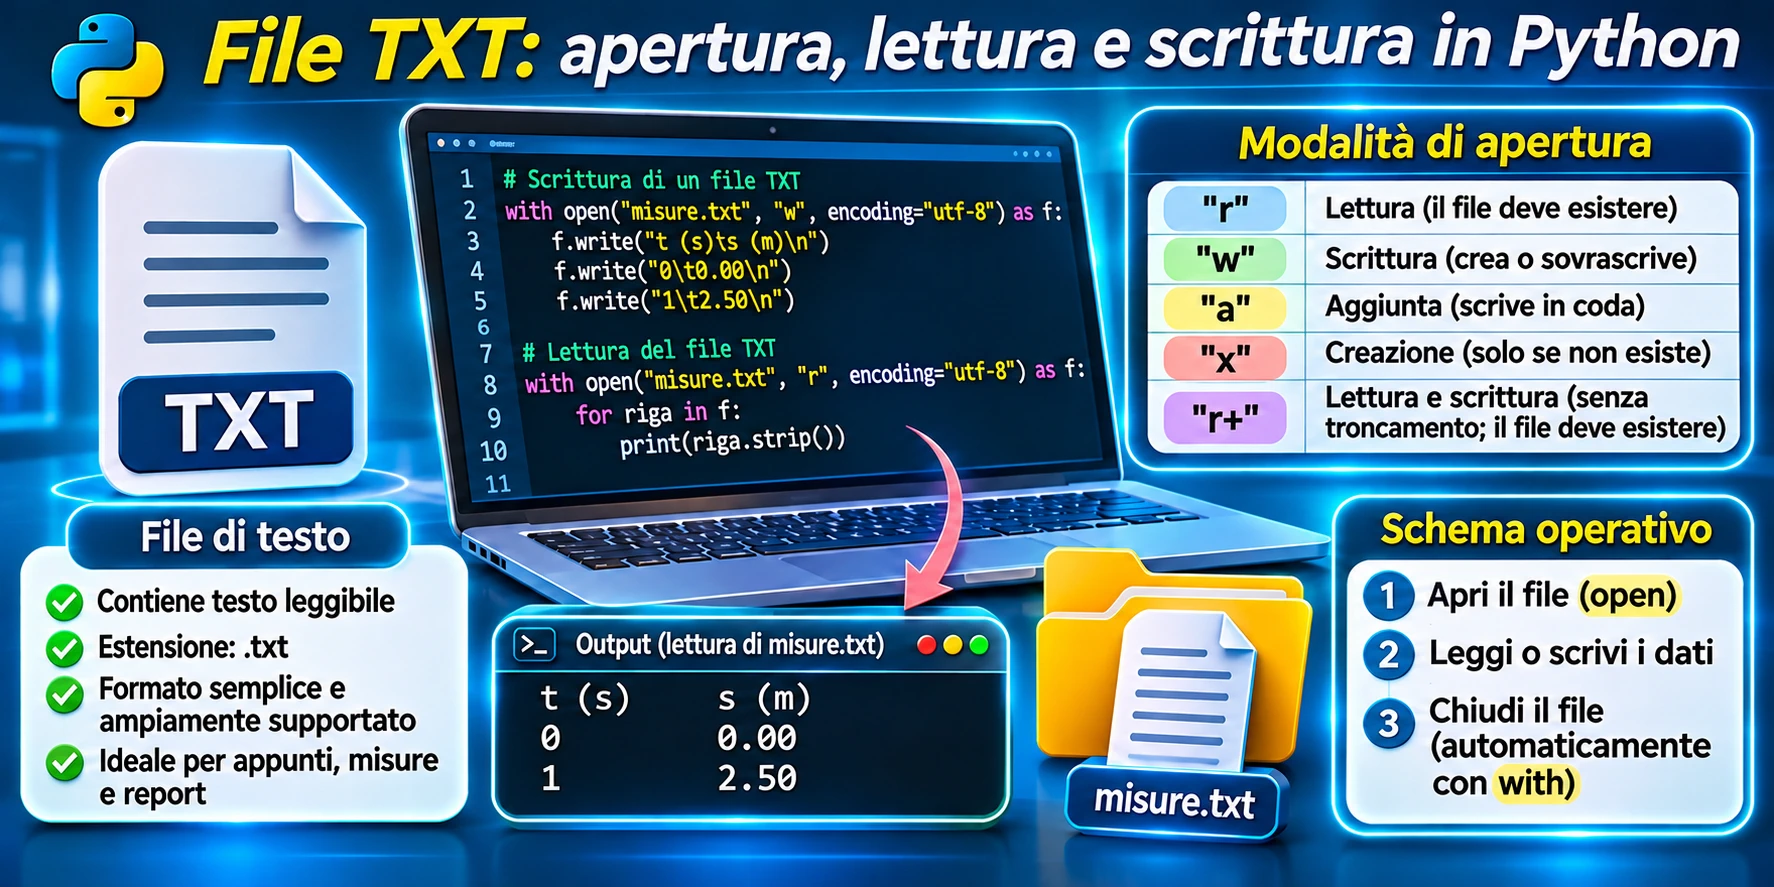
La funzione open(percorso, modalità, encoding=…) restituisce un oggetto file. Le modalità più usate sono r (lettura, il file deve esistere), w (scrittura, crea o tronca), a (aggiunta alla fine, crea se manca), x (creazione esclusiva: genera errore se il file esiste). Il suffisso b lavora su byte; t indica il testo ed è la scelta predefinita.
Il metodo close() libera le risorse, ma una eccezione prima di close() può impedire la chiusura. Il costrutto with è un context manager: gestisce l'uscita dal blocco e chiude automaticamente il file anche quando si verifica un errore. L'oggetto file non garantisce che il dato sia diventato immediatamente durevole sul supporto fisico; per gli esercizi scolastici with è il modello standard.
| Modalità | Scopo | Se file manca | Se file esiste |
|---|---|---|---|
| r | Leggere | Errore | Non modifica |
| w | Scrivere | Crea | Tronca |
| a | Aggiungere | Crea | Accoda |
| x | Creare esclusivamente | Crea | Errore |
Esempio Python 3.13
from pathlib import Path
p = Path("esempio_14_02.txt")
with p.open("w", encoding="utf-8") as file:
    file.write("Misura registrata\n")
with p.open("r", encoding="utf-8") as file:
    print(file.read().strip())
p.unlink()
Output verificato
14.3 — Scrivere file TXT
write() scrive una stringa, non aggiunge automaticamente la nuova riga. writelines() riceve un iterabile di stringhe ma non inserisce separatori: occorre fornire \n dove necessario. Gli interi o i float devono essere trasformati in testo (str o f-string).
La modalità w sovrascrive il contenuto precedente: usare a quando l'obiettivo è accodare nuovi dati. Per un nuovo file che non deve esistere utilizzare x. Per programmi che mantengono dati importanti, valutare copie e scritture temporanee prima della sostituzione.
Esempio Python 3.13
from pathlib import Path
p = Path("esempio_14_03.txt")
with p.open("w", encoding="utf-8") as f:
    f.write(f"Temperatura: {21.345:.2f} °C\n")
with p.open("a", encoding="utf-8") as f:
    f.writelines(["Giorno: lunedì\n", "Sensore: A\n"])
print(p.read_text(encoding="utf-8").strip())
p.unlink()
Output verificato
Giorno: lunedì
Sensore: A
14.4 — Leggere file TXT
read() acquisisce tutto il contenuto come stringa; read(n) limita la lettura a n caratteri in modalità testo. readline() legge una riga; readlines() restituisce una lista di righe. Per grandi file è preferibile un ciclo for sul file: le righe vengono elaborate progressivamente anziché caricando l'intero file in una sola struttura.
Per togliere solo il terminatore di riga si può utilizzare rstrip("\r\n"); strip() elimina anche gli spazi iniziali e finali e può modificare dati significativi. Un file vuoto produce una stringa vuota con read() e nessuna iterazione nel ciclo.
Esempio Python 3.13
from pathlib import Path
p = Path("esempio_14_04.txt")
p.write_text("A,18\nB,20\nC,19\n", encoding="utf-8")
with p.open(encoding="utf-8") as f:
    for numero, riga in enumerate(f, 1):
        print(numero, riga.rstrip("\r\n"))
p.unlink()
Output verificato
2 B,20
3 C,19
14.5 — Codifica dei caratteri
Unicode assegna punti di codice ai caratteri; UTF-8 codifica tali caratteri in sequenze di byte di lunghezza variabile. ASCII rappresenta un sottoinsieme storico di 128 caratteri: un file con lettere accentate richiede una codifica adeguata. La stringa Python è testo Unicode; i file salvano byte codificati. Specificare encoding="utf-8" rende esplicita la scelta e migliora la portabilità.
Una decodifica con codifica sbagliata può sollevare UnicodeDecodeError oppure produrre caratteri errati. Non ignorare silenziosamente questi problemi se le misure o le etichette hanno valore scientifico.
Esempio Python 3.13
testo = "Città"
byte_utf8 = testo.encode("utf-8")
print(byte_utf8.hex(" "))
print(byte_utf8.decode("utf-8"))
Output verificato
Città
14.6 — Percorsi e directory
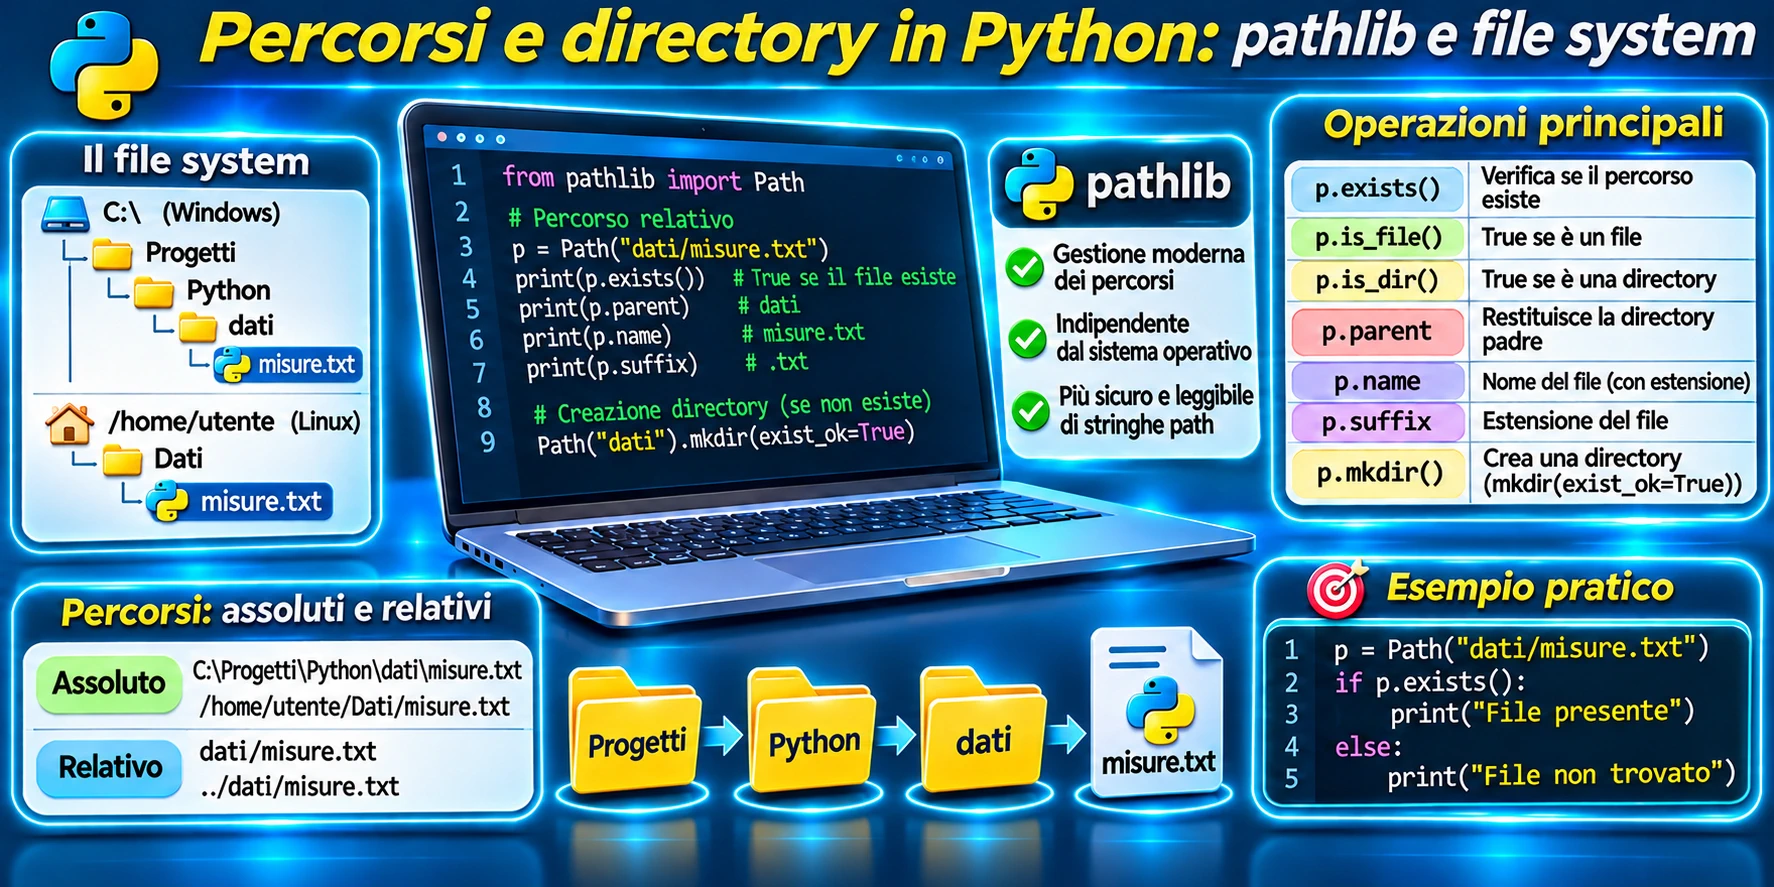
Un percorso assoluto identifica un elemento a partire dalla radice del file system; un percorso relativo viene risolto rispetto alla directory di lavoro corrente, che può essere diversa dalla cartella dello script. Path.cwd() indica la directory corrente e Path.home() la cartella dell'utente. Su Windows sono tipici percorsi con lettere di unità, mentre Linux e macOS usano radici come /.
pathlib.Path costruisce percorsi senza concatenare manualmente separatori: il simbolo / fra oggetti Path e componenti stringa non esegue una divisione. Per file collegati allo script spesso conviene Path(__file__).resolve().parent; questo identificatore è disponibile negli script .py ma non sempre in contesti interattivi.
Esempio Python 3.13
from pathlib import Path
base = Path("esperimento")
file = base / "misure" / "dati.txt"
print(file.parts[-2:])
Output verificato
14.7 — Gestione dei file con pathlib
exists() controlla l'esistenza; is_file() e is_dir() distinguono i tipi di elementi; mkdir(parents=True, exist_ok=True) crea una directory e le sue parent se assenti; iterdir() elenca il contenuto immediato; glob("*.csv") seleziona nomi secondo un pattern. read_text(encoding=…) e write_text(…, encoding=…) offrono scorciatoie per file testuali, mentre read_bytes() e write_bytes() gestiscono byte.
Attenzione: controllare exists() e aprire successivamente non è un'operazione atomica: fra le due istruzioni un altro processo può cambiare il file. Occorre comunque gestire gli errori dell'operazione effettiva. Non cancellare né sovrascrivere file personali durante gli esperimenti.
Esempio Python 3.13
from pathlib import Path
cartella = Path("demo_pathlib_14")
cartella.mkdir(exist_ok=True)
p = cartella / "prova.txt"
p.write_text("OK", encoding="utf-8")
print(p.is_file(), len(list(cartella.glob("*.txt"))))
p.unlink()
cartella.rmdir()
Output verificato
14.8 — Gestione degli errori nelle operazioni sui file
FileNotFoundError segnala un elemento assente; PermissionError un accesso non consentito; IsADirectoryError compare quando si usa una directory come file; UnicodeDecodeError segnala byte incompatibili con la codifica richiesta; OSError è una famiglia più generale di errori del sistema operativo.
Un blocco try contiene l'operazione a rischio; except intercetta condizioni specifiche; else si esegue solo se non si è verificata un'eccezione nel try; finally si esegue in ogni caso (salvo terminazioni anomale del processo). Evitare except Exception indiscriminato perché nasconde errori logici. La gestione errori protegge il flusso del programma ma non sostituisce il backup.
Esempio Python 3.13
from pathlib import Path
p = Path("file_inesistente_esempio_14_08.txt")
try:
    contenuto = p.read_text(encoding="utf-8")
except FileNotFoundError:
    print("File assente: verifica il percorso")
else:
    print(contenuto)
finally:
    print("Operazione conclusa")
Output verificato
Operazione conclusa
14.9 — File CSV: struttura e caratteristiche
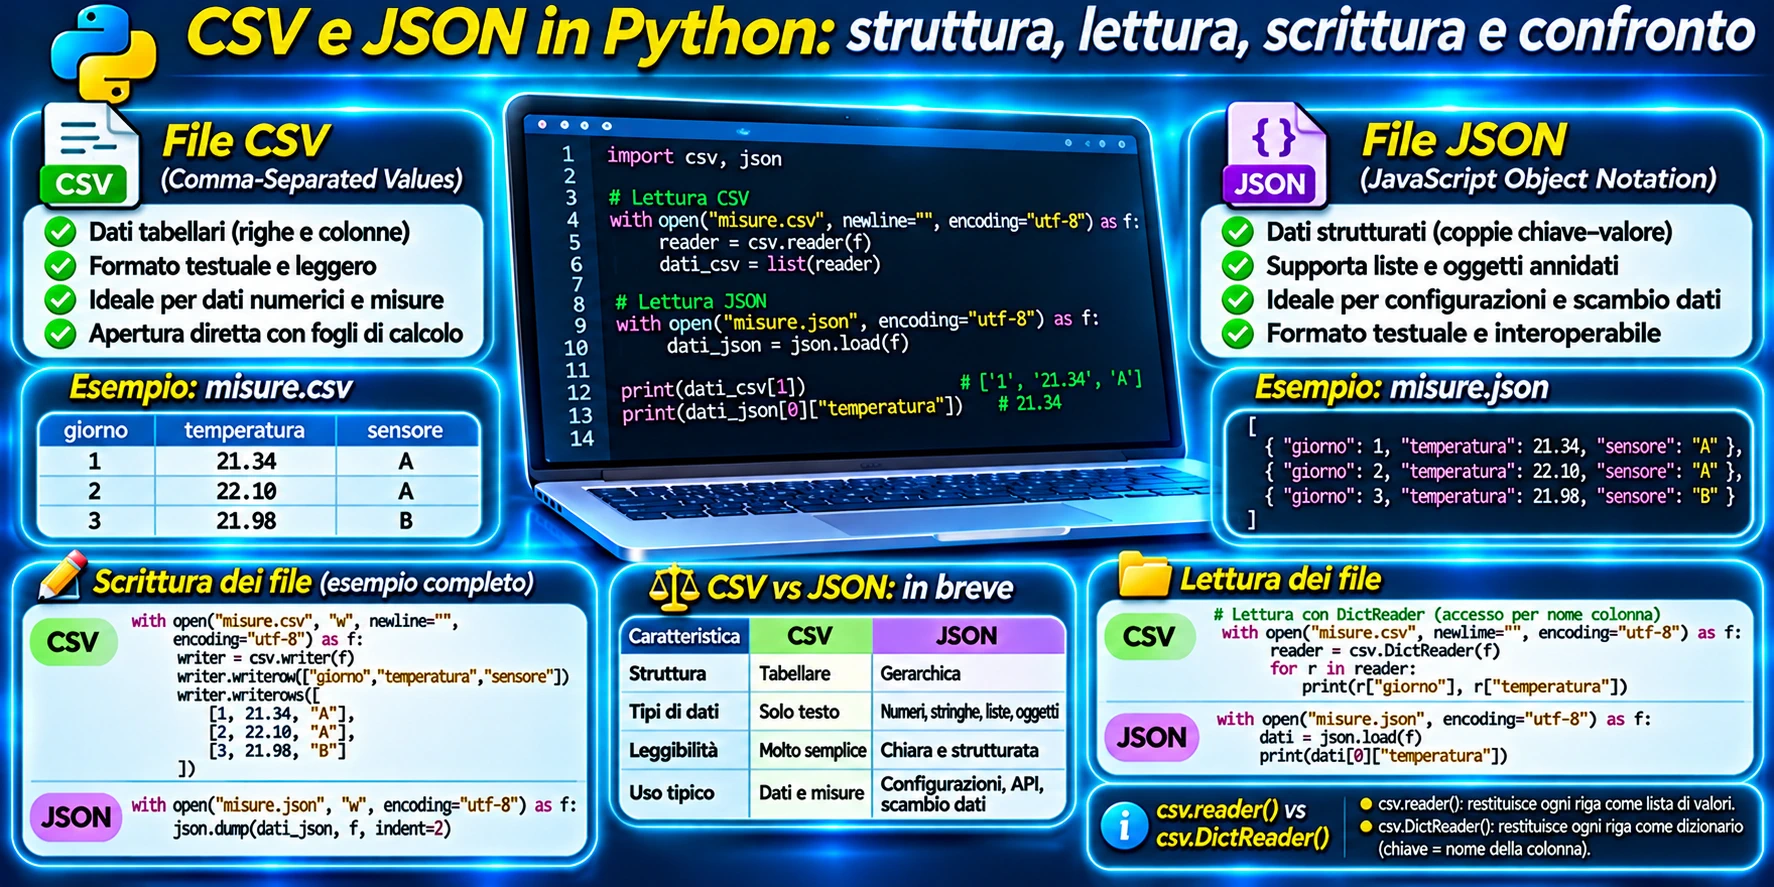
CSV significa Comma-Separated Values, ma i dialetti CSV possono utilizzare anche il punto e virgola. Il contenuto è una tabella di record (righe) e campi (colonne); la prima riga è spesso un'intestazione, ma non è obbligatoria. Un campo che contiene il delimitatore può essere racchiuso fra virgolette e le virgolette interne vengono opportunamente raddoppiate.
Per questo una generica split(",") non interpreta correttamente i CSV con virgole all'interno dei campi. I valori letti sono stringhe: convertire esplicitamente le colonne numeriche. Un valore vuoto non coincide sempre con zero. I fogli elettronici possono importare CSV scegliendo delimitatore e codifica.
Esempio Python 3.13
import csv, io
s = 'nome,nota\nA,"12,5 cm"\n'
righe = list(csv.reader(io.StringIO(s)))
print(righe[1][1])
Output verificato
14.10 — Leggere e scrivere CSV con Python
Il modulo standard csv mette a disposizione reader e writer per righe di campi, DictReader e DictWriter per righe associate a nomi di colonna. Aprire i CSV con newline="" permette al modulo csv di gestire correttamente i terminatori di riga; aggiungere encoding="utf-8". La scrittura delle intestazioni è esplicita con writeheader() in DictWriter.
I valori letti sono stringhe: applicare float o int soltanto dopo controllo di valori mancanti e validità. Il CSV non dispone di tipi incorporati o di uno schema obbligatorio: la validazione compete al programma.
Esempio Python 3.13
from pathlib import Path
import csv
p = Path("esempio_14_10.csv")
with p.open("w", encoding="utf-8", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["sensore", "temperatura"])
    w.writeheader(); w.writerow({"sensore":"A", "temperatura":"21.5"})
with p.open("r", encoding="utf-8", newline="") as f:
    r = list(csv.DictReader(f))
print(r[0]["sensore"], f'{float(r[0]["temperatura"]):.2f}')
p.unlink()
Output verificato
14.11 — Elaborazione di dati scientifici CSV
Una tabella di misure richiede un algoritmo riproducibile: leggere l'intestazione, selezionare la colonna, scartare o segnalare valori vuoti/non validi, contare le osservazioni valide, calcolare media, minimo e massimo, quindi esportare i risultati. Occorre documentare la scelta di scartare i dati, per evitare conclusioni distorte.
La media aritmetica delle n misure valide è la somma divisa per n, per n>0. Per un file senza valori validi, la media non è definita: non dividere per zero. Il risultato può essere confrontato con MEDIA, MIN e MAX di un foglio elettronico, dopo aver concordato come trattare i mancanti.
Media aritmetica: x̄ = (x₁ + x₂ + … + xₙ) / n, con n > 0
Esempio Python 3.13
valori = [18.5, None, 20.0, 19.5, 21.0]
validi = [x for x in valori if x is not None]
print(f"n={len(validi)}; media={sum(validi)/len(validi):.2f}; "
      f"min={min(validi):.2f}; max={max(validi):.2f}")
Output verificato
14.12 — Introduzione al formato JSON
JSON (JavaScript Object Notation) è un formato testuale per lo scambio di dati strutturati, indipendente dal linguaggio Python. Supporta oggetti con chiavi stringa, array ordinati, stringhe, numeri, true, false e null. Non supporta commenti né valori Python come set o tuple come tipi distinti; la rappresentazione JSON di un tuple diventa generalmente un array.
Il CSV è adatto a tabelle regolari, JSON a strutture annidate, TXT a resoconti leggibili. Nessuno dei tre sostituisce automaticamente un DBMS quando sono richieste interrogazioni complesse, transazioni o accessi concorrenti.
Esempio Python 3.13
import json
oggetto = {"luogo": "laboratorio", "valori": [18, 19], "valido": True, "nota": None}
print(json.dumps(oggetto, ensure_ascii=False))
Output verificato
14.13 — Leggere e scrivere JSON
json.dumps() converte un oggetto Python in una stringa JSON; json.dump() scrive su uno stream di testo. json.loads() interpreta una stringa; json.load() legge e interpreta da uno stream. ensure_ascii=False conserva i caratteri non ASCII leggibili nella stringa; indent=2 formatta il risultato.
La lettura può causare JSONDecodeError su sintassi non valida. Inoltre un JSON sintatticamente valido potrebbe non rispettare lo schema applicativo: verificare ad esempio che la radice sia una lista e che ogni osservazione abbia valore numerico e unità conosciuta. Attenzione a nan e Infinity: non sono numeri JSON standard; se si serializzano dati scientifici rigorosi, usare allow_nan=False.
Esempio Python 3.13
from pathlib import Path
import json
p = Path("esempio_14_13.json")
dati = {"città": "Roma", "misure": [12.5, 13.5]}
with p.open("w", encoding="utf-8") as f:
    json.dump(dati, f, ensure_ascii=False, indent=2, allow_nan=False)
with p.open("r", encoding="utf-8") as f:
    recuperati = json.load(f)
print(recuperati["città"], len(recuperati["misure"]))
p.unlink()
Output verificato
14.14 — File binari
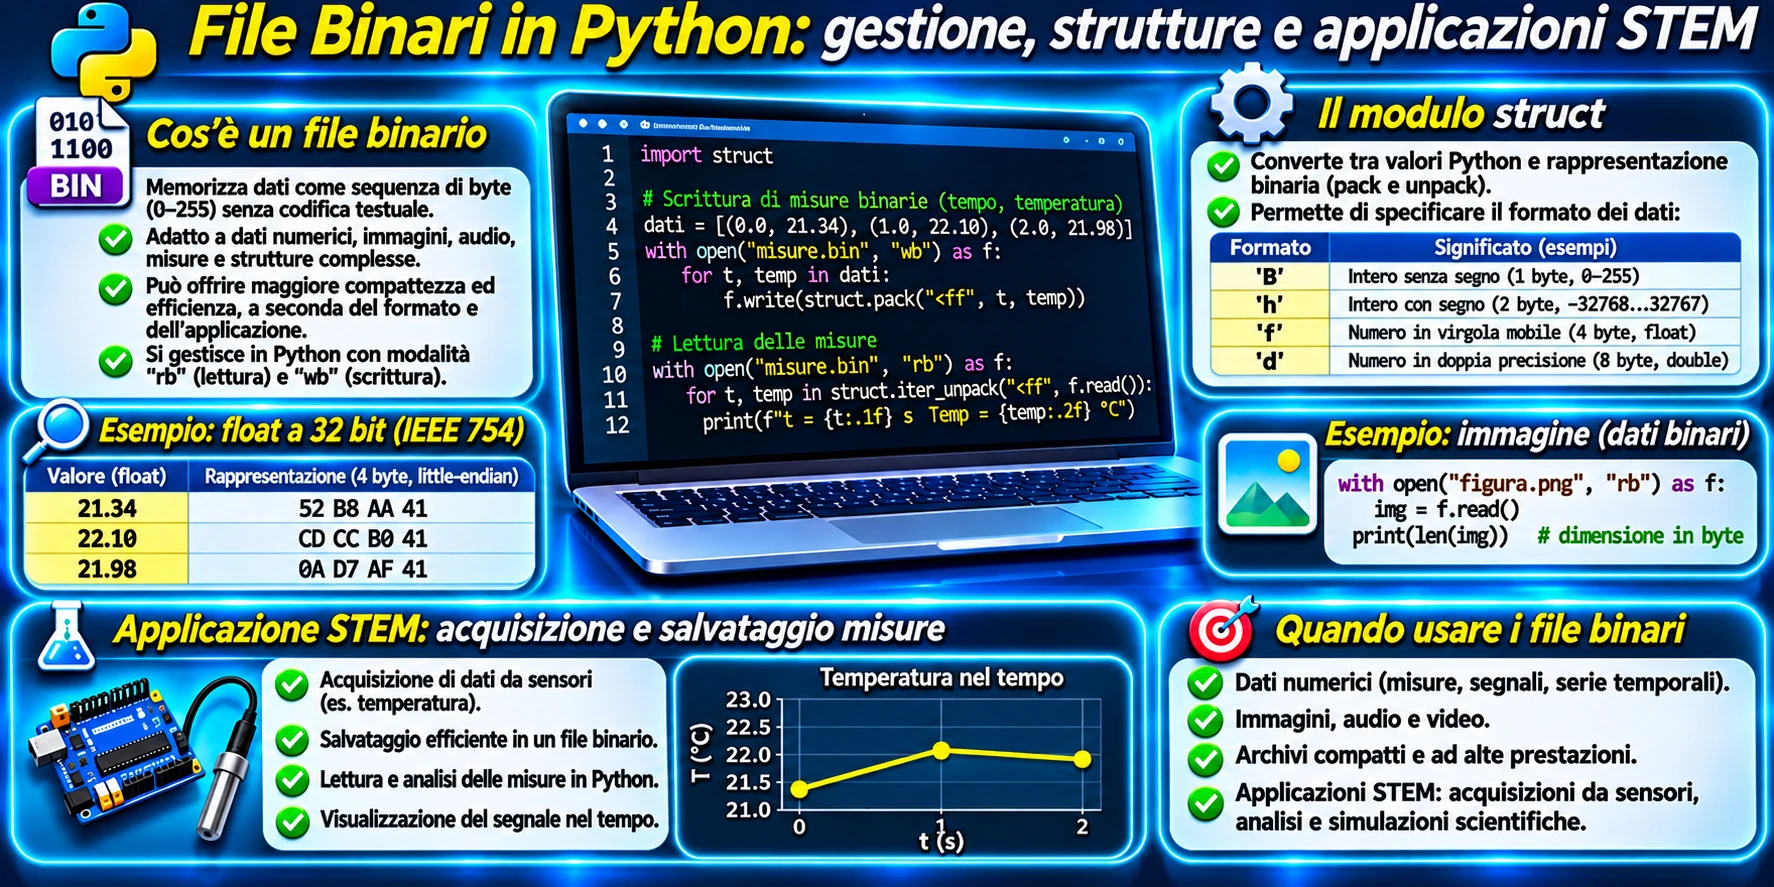
Un file binario conserva byte senza codifica testuale obbligatoria. bytes è una sequenza immutabile di interi fra 0 e 255; rb e wb permettono lettura e scrittura. La lunghezza in byte si legge con len(data) oppure con Path.stat().st_size. Una sequenza di byte non indica da sola che cosa rappresenti: servono specifiche sul formato, ordine dei byte (endianness), segno e dimensione dei campi.
Il modulo struct trasforma valori numerici in sequenze di byte e viceversa; per esempio <H indica un intero senza segno a 16 bit in ordine little-endian. Evitare pickle con dati di provenienza sconosciuta perché la deserializzazione può eseguire codice non attendibile.
Esempio Python 3.13
import struct
campioni = bytes([12, 255, 0, 34])
print(campioni.hex(" "))
print(struct.unpack("<H", campioni[:2])[0])
Output verificato
65292
14.15 — Organizzazione e sicurezza dei dati
Destinare gli esperimenti a una cartella di lavoro separata, utilizzare nomi prevedibili, controllare gli input e non fidarsi dell'estensione come prova del formato. La modalità x evita una sovrascrittura involontaria; w è distruttiva verso il contenuto precedente. Se i nomi vengono digitati dagli utenti, non concatenarli direttamente a percorsi sensibili: meglio scegliere da un elenco di nomi consentiti.
Per operazioni importanti conservare una copia di sicurezza e valutare una scrittura temporanea nella stessa directory, seguita da sostituzione. Tale tecnica limita il rischio di file incompleti, ma non elimina problemi di concorrenza o guasto. Controllare che la directory sia scrivibile, validare dimensioni e codifiche e chiudere i file con with.
Esempio Python 3.13
from pathlib import Path
from tempfile import TemporaryDirectory
with TemporaryDirectory() as cartella_temporanea:
    p = Path(cartella_temporanea) / "esempio.txt"
    with p.open("x", encoding="utf-8") as f:
        f.write("Nuovo archivio")
    print("Creato senza sovrascrivere")
Output verificato
14.16 — Applicazioni STEM
I tre esperimenti applicano la stessa procedura scientifica: formulare il problema, definire formato e unità, registrare misure, controllare i dati, elaborare un indicatore e interpretare il risultato. Gli esempi usano una cartella temporanea, così non alterano documenti personali. Tutti i frammenti sono autonomi ed eseguibili singolarmente.
Esperimento A — Diario di misure fisiche TXT
Problema. Misurare tre volte la lunghezza di un oggetto e conservare i valori per un’analisi successiva. Dati iniziali: 12,40 cm; 12,60 cm; 12,50 cm. Algoritmo: creare un file di testo, registrare una misura per riga, rileggere progressivamente, convertire in numeri e calcolare media, minimo e massimo. L’unità è documentata nell’intestazione.
from pathlib import Path
from tempfile import TemporaryDirectory

misure = [12.40, 12.60, 12.50]
with TemporaryDirectory() as tmp:
    file = Path(tmp) / "lunghezze.txt"
    with file.open("w", encoding="utf-8") as f:
        f.write("# Lunghezze in cm\n")
        for misura in misure:
            f.write(f"{misura:.2f}\n")
    valori = []
    with file.open("r", encoding="utf-8") as f:
        for riga in f:
            riga = riga.strip()
            if not riga or riga.startswith("#"):
                continue
            try:
                valori.append(float(riga))
            except ValueError:
                print("Riga non numerica ignorata:", riga)
    if valori:
        print(f"TXT: n={len(valori)}; media={sum(valori)/len(valori):.2f} cm")
        print(f"Min={min(valori):.2f}; max={max(valori):.2f} cm")
    else:
        print("Nessuna misura valida: media non calcolabile")
Output verificabile
Min=12.40; max=12.60 cm
Interpretazione. Le tre misure sono vicine e la media è 12,50 cm; per valutare l’accuratezza serve anche conoscere incertezza e calibrazione dello strumento. Casi limite: file vuoto, commenti, righe non numeriche; in assenza di misure valide non si divide per zero.
Esperimento B — Analisi di temperature CSV
Problema. Analizzare una serie di temperature e produrre un riepilogo esportabile. Dati iniziali: 18,50; 20,00; dato mancante; 19,50; 21,00 °C. Algoritmo: produrre un CSV con intestazione, importarlo tramite csv.DictReader, contare i mancanti e gli eventuali valori non validi, calcolare gli estremi e scrivere un report TXT. Un valore vuoto non equivale a 0 °C.
from pathlib import Path
from tempfile import TemporaryDirectory
import csv
import math

righe = [("Lun", "18.5"), ("Mar", "20.0"),
         ("Mer", ""), ("Gio", "19.5"), ("Ven", "21.0")]
with TemporaryDirectory() as tmp:
    base = Path(tmp)
    csv_file = base / "temperature.csv"
    with csv_file.open("w", encoding="utf-8", newline="") as f:
        writer = csv.writer(f)
        writer.writerow(["giorno", "temperatura_C"])
        writer.writerows(righe)
    validi, scartati = [], 0
    with csv_file.open("r", encoding="utf-8", newline="") as f:
        for riga in csv.DictReader(f):
            testo = (riga.get("temperatura_C") or "").strip()
            try:
                valore = float(testo)
                if not math.isfinite(valore) or not -100 <= valore <= 100:
                    raise ValueError("Fuori intervallo")
                validi.append(valore)
            except ValueError:
                scartati += 1
    report = base / "riepilogo.txt"
    if validi:
        risultato = (f"CSV: n={len(validi)}; scartati={scartati}\n"
                     f"Media={sum(validi)/len(validi):.2f} °C\n"
                     f"Min={min(validi):.2f} °C; max={max(validi):.2f} °C")
    else:
        risultato = f"Nessun dato valido; scartati={scartati}"
    report.write_text(risultato + "\n", encoding="utf-8")
    print(report.read_text(encoding="utf-8"), end="")
Output verificabile
Media=19.75 °C
Min=18.50 °C; max=21.00 °C
Interpretazione. La media si riferisce a quattro osservazioni, non cinque: occorre dichiarare il dato mancante in qualsiasi confronto con un foglio elettronico. Casi limite: CSV senza intestazioni, righe incomplete, stringhe non numeriche, NaN e serie priva di osservazioni valide: vanno segnalati, non trasformati in zero.
Esperimento C — Archivio di osservazioni JSON
Problema. Conservare osservazioni con nome, valore e unità, poi aggiungere un nuovo campione. Dati: A = 10,25 g; B = 9,75 g; nuovo campione C = 10,00 g. Algoritmo: creare archivio JSON, rileggerlo, validare struttura e unità, aggiungere il campione, salvare e verificare il contenuto ricaricato.
from pathlib import Path
from tempfile import TemporaryDirectory
import json
import math

iniziali = [{"nome": "A", "valore": 10.25, "unita": "g"},
           {"nome": "B", "valore": 9.75, "unita": "g"}]
with TemporaryDirectory() as tmp:
    file = Path(tmp) / "osservazioni.json"
    file.write_text(json.dumps(iniziali, ensure_ascii=False, indent=2,
                               allow_nan=False), encoding="utf-8")
    dati = json.loads(file.read_text(encoding="utf-8"))
    if not isinstance(dati, list) or not all(
        isinstance(r, dict) and isinstance(r.get("nome"), str)
        and type(r.get("valore")) in (int, float)
        and math.isfinite(r["valore"]) and r.get("unita") == "g"
        for r in dati
    ):
        raise ValueError("Archivio JSON non valido")
    nuovo = {"nome": "C", "valore": 10.0, "unita": "g"}
    if any(r["nome"] == nuovo["nome"] for r in dati):
        raise ValueError("Nome campione duplicato")
    dati.append(nuovo)
    file.write_text(json.dumps(dati, ensure_ascii=False, indent=2,
                               allow_nan=False), encoding="utf-8")
    riletti = json.loads(file.read_text(encoding="utf-8"))
    media = sum(r["valore"] for r in riletti) / len(riletti)
    print(f"JSON: n={len(riletti)}; media={media:.2f} g")
    print("Campioni:", ", ".join(r["nome"] for r in riletti))
Output verificabile
Campioni: A, B, C
Interpretazione. JSON conserva una struttura più articolata rispetto al CSV, ma l'applicazione deve definire e verificare quali campi sono obbligatori. Casi limite: JSON malformato (json.JSONDecodeError), unità incompatibili, nomi duplicati e numeri non finiti. Un archivio non valido non deve essere sovrascritto.
14.17 — Progetto Python STEM scaricabile
Il progetto MEGI — Gestore di file e dati scientifici Python è un programma autonomo con quattro modalità: diario TXT (accoda misure), CSV (legge temperature e produce un report), JSON (registra osservazioni e mantiene una lista persistente), binari (crea un campione e mostra byte/esadecimale/interpretazione a 16 bit).
Usa soltanto moduli della libreria standard: pathlib, csv, json, struct. Le operazioni avvengono nella directory dati_megi, creata a fianco dello script, senza percorsi assoluti fissi verso file personali. I dati campione non vengono reinizializzati automaticamente se già presenti. Il progetto completo è disponibile tramite il pulsante arancione seguente. Scarica l'archivio ZIP, estrai i file in una cartella del computer e avvia il programma con IDLE o Visual Studio Code.
🐍 SCARICA IL PROGETTO PYTHON STEM
Progetto MEGISTONE B1.06 — Archivio ZIP
con programma Python e materiali di esercitazione.
Esempio Python 3.13
# Estratto del progetto autonomo (il file completo è incluso nello ZIP)
from pathlib import Path
BASE = Path(__file__).resolve().parent / "dati_megi"
BASE.mkdir(exist_ok=True)
print("Cartella dati:", BASE.name)
Output verificato
Esplora il laboratorio Python interattivo:
file TXT, percorsi, CSV, JSON, binari
e applicazioni STEM.
14.18 — Allenati con MEGI
Venti esercizi progressivi, suddivisi in livelli A–E. Per ciascun esercizio leggi obiettivo e traccia, prova a risolvere da solo e apri la soluzione soltanto dopo avere verificato il tuo ragionamento. Le soluzioni sono commentate e includono il risultato atteso quando pertinente.
Esercizio 01/20 · Livello A
Distinguere memoria e file
Obiettivo: Distinguere memoria e file.
Traccia: Perché una lista Python non è automaticamente permanente?
Mostra soluzione e risultato
Soluzione commentata: Una lista vive nella memoria del processo. Per conservarla serve una scrittura su un supporto persistente, per esempio un file.
Risultato atteso: La lista non resta automaticamente disponibile dopo la chiusura.
Esercizio 02/20 · Livello A
Conoscere le modalità
Obiettivo: Conoscere le modalità.
Traccia: Associa r, w, a, x a lettura, sovrascrittura, aggiunta e creazione esclusiva.
Mostra soluzione e risultato
Soluzione commentata: r=lettura; w=scrittura che tronca; a=aggiunta; x=crea solo se non esiste.
Risultato atteso: r → lettura; w → tronca; a → accoda; x → esclusiva.
Esercizio 03/20 · Livello A
Testo e binario
Obiettivo: Testo e binario.
Traccia: Spiega la differenza fra una stringa Unicode e bytes.
Mostra soluzione e risultato
Soluzione commentata: La stringa rappresenta caratteri; bytes rappresenta byte (interi 0–255). encode/decode collegano le due rappresentazioni secondo una codifica.
Risultato atteso: "è".encode("utf-8") produce b"\xc3\xa8".
Esercizio 04/20 · Livello A
Percorsi relativi
Obiettivo: Percorsi relativi.
Traccia: Che cosa cambia fra Path("dati.csv") e Path.cwd()?
Mostra soluzione e risultato
Soluzione commentata: Il primo descrive un percorso relativo; il secondo restituisce il percorso assoluto della directory di lavoro corrente.
Risultato atteso: Path("dati.csv") dipende dalla directory corrente.
Esercizio 05/20 · Livello B
Tracciare append
Obiettivo: Tracciare append.
Traccia: Un file contiene A. Esegui una scrittura in a con B. Che cosa contiene?
Mostra soluzione e risultato
Soluzione commentata: La modalità a accoda senza eliminare A. Se si scrive "B" senza newline, il risultato è "AB".
Risultato atteso: AB
Esercizio 06/20 · Livello B
Contare le righe
Obiettivo: Contare le righe.
Traccia: Per righe=["A\n","B\n","C\n"], quanto vale len(righe)?
Mostra soluzione e risultato
Soluzione commentata: La lista contiene tre elementi, ciascuno con terminatore di riga.
Risultato atteso: 3
Esercizio 07/20 · Livello B
Calcolare la media
Obiettivo: Calcolare la media.
Traccia: Misure 18.0, 20.0, 22.0: calcola media e range.
Mostra soluzione e risultato
Soluzione commentata: La media è (18+20+22)/3=20; il range è 22−18=4.
Risultato atteso: Media 20.00; range 4.00
Esercizio 08/20 · Livello B
Interpretare i byte
Obiettivo: Interpretare i byte.
Traccia: Quanto vale bytes([0,255]).hex(" ")?
Mostra soluzione e risultato
Soluzione commentata: I due byte sono 00 e ff in esadecimale.
Risultato atteso: 00 ff
Esercizio 09/20 · Livello C
Correggere write
Obiettivo: Correggere write.
Traccia: Correggi: f.write(12.5).
Mostra soluzione e risultato
Soluzione commentata: write richiede una stringa: f.write(str(12.5)) oppure f.write(f"{12.5:.2f}").
Risultato atteso: Scrive 12.5 oppure 12.50
Esercizio 10/20 · Livello C
Correggere CSV
Obiettivo: Correggere CSV.
Traccia: Perché csv_line.split(",") non è affidabile?
Mostra soluzione e risultato
Soluzione commentata: Un campo tra virgolette può contenere virgole. Utilizzare csv.reader o DictReader.
Risultato atteso: Il campo "12,5 cm" resta integro.
Esercizio 11/20 · Livello C
Correggere newline
Obiettivo: Correggere newline.
Traccia: Perché bisogna usare newline="" con csv.writer?
Mostra soluzione e risultato
Soluzione commentata: Il modulo csv deve controllare i terminatori di riga per evitare comportamenti non desiderati fra sistemi operativi.
Risultato atteso: Un record per riga nel CSV.
Esercizio 12/20 · Livello C
Intercettare errori
Obiettivo: Intercettare errori.
Traccia: Sostituisci except Exception con gestione mirata per file assente.
Mostra soluzione e risultato
Soluzione commentata: Usa except FileNotFoundError: ...; per altri problemi prevedi eccezioni pertinenti senza nascondere bug.
Risultato atteso: Un messaggio esplicito per il file mancante.
Esercizio 13/20 · Livello D
Scrivere un file
Obiettivo: Scrivere un file.
Traccia: Scrivi due righe TXT, "A" e "B", in UTF-8.
Mostra soluzione e risultato
Soluzione commentata: with open("dati.txt","w",encoding="utf-8") as f: f.write("A\nB\n") . La modalità w sovrascrive il contenuto preesistente.
Risultato atteso: Due righe: A e B
Esercizio 14/20 · Livello D
Leggere riga per riga
Obiettivo: Leggere riga per riga.
Traccia: Conta le righe non vuote di un file TXT senza caricarlo tutto in memoria.
Mostra soluzione e risultato
Soluzione commentata: with open("dati.txt",encoding="utf-8") as f: n=sum(1 for r in f if r.strip()) . Il generatore tratta progressivamente le righe.
Risultato atteso: n pari al numero di righe non vuote.
Esercizio 15/20 · Livello D
Scrivere DictWriter
Obiettivo: Scrivere DictWriter.
Traccia: Produci un CSV con intestazioni nome e misura.
Mostra soluzione e risultato
Soluzione commentata: Codice completo da eseguire in una cartella di esercitazione:
import csv
with open("m.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.DictWriter(f, fieldnames=["nome", "misura"])
    w.writeheader()
    w.writerow({"nome": "A", "misura": 2.5})
with open("m.csv", encoding="utf-8", newline="") as f:
    print(f.read().strip())
Risultato atteso: Intestazione nome,misura e record A,2.5.
Esercizio 16/20 · Livello D
Salvare JSON
Obiettivo: Salvare JSON.
Traccia: Scrivi in JSON il dizionario {"ok":True,"nota":None}.
Mostra soluzione e risultato
Soluzione commentata: import json; json.dumps({"ok":True,"nota":None}) produce un oggetto JSON; su file usare json.dump con with e UTF-8.
Risultato atteso: {"ok": true, "nota": null}
Esercizio 17/20 · Livello E
Diario scientifico
Obiettivo: Diario scientifico.
Traccia: Dati tre tempi: 1.20, 1.25, 1.15 s. Calcola media e salva in TXT.
Mostra soluzione e risultato
Soluzione commentata: t=[1.20,1.25,1.15]; m=sum(t)/len(t); Path("riepilogo.txt").write_text(f"Media: {m:.2f} s",encoding="utf-8").
Risultato atteso: Media: 1.20 s
Esercizio 18/20 · Livello E
Temperature con mancanti
Obiettivo: Temperature con mancanti.
Traccia: Serie 20, valore mancante, 22, 24 °C. Calcola media solo dei validi.
Mostra soluzione e risultato
Soluzione commentata: v=[20,None,22,24]; ok=[x for x in v if x is not None]; sum(ok)/len(ok)=22.0. Conta separatamente i mancanti.
Risultato atteso: Media 22.00 °C; 1 mancante.
Esercizio 19/20 · Livello E
Archivio con controllo
Obiettivo: Archivio con controllo.
Traccia: Prima di aggiungere un elemento JSON, verifica che la radice sia una lista.
Mostra soluzione e risultato
Soluzione commentata: Codice completo da eseguire in una cartella di esercitazione:
import json
testo = '{"osservazioni": []}'
dati = json.loads(testo)
if not isinstance(dati, list):
    raise ValueError("Archivio non valido: è richiesta una lista")
Risultato atteso: Il dizionario alla radice viene rifiutato con ValueError.
Esercizio 20/20 · Livello E
Formato binario
Obiettivo: Formato binario.
Traccia: Interpreta bytes([1,0]) come <H usando struct.
Mostra soluzione e risultato
Soluzione commentata: struct.unpack("<H",bytes([1,0]))[0] restituisce 1: il byte meno significativo viene per primo.
Risultato atteso: 1